ReplaySSM:缓存输入而非状态
来源: ReplaySSM: Cache SSM Inputs, Not State — Dao AI Lab,2026-06-15
ReplaySSM 不再每步写回完整的 recurrent state,而是保留一个 checkpoint state,并缓存最近的状态更新输入。需要时再重建状态;只需要输出时,则直接从 checkpoint 和缓存计算输出。
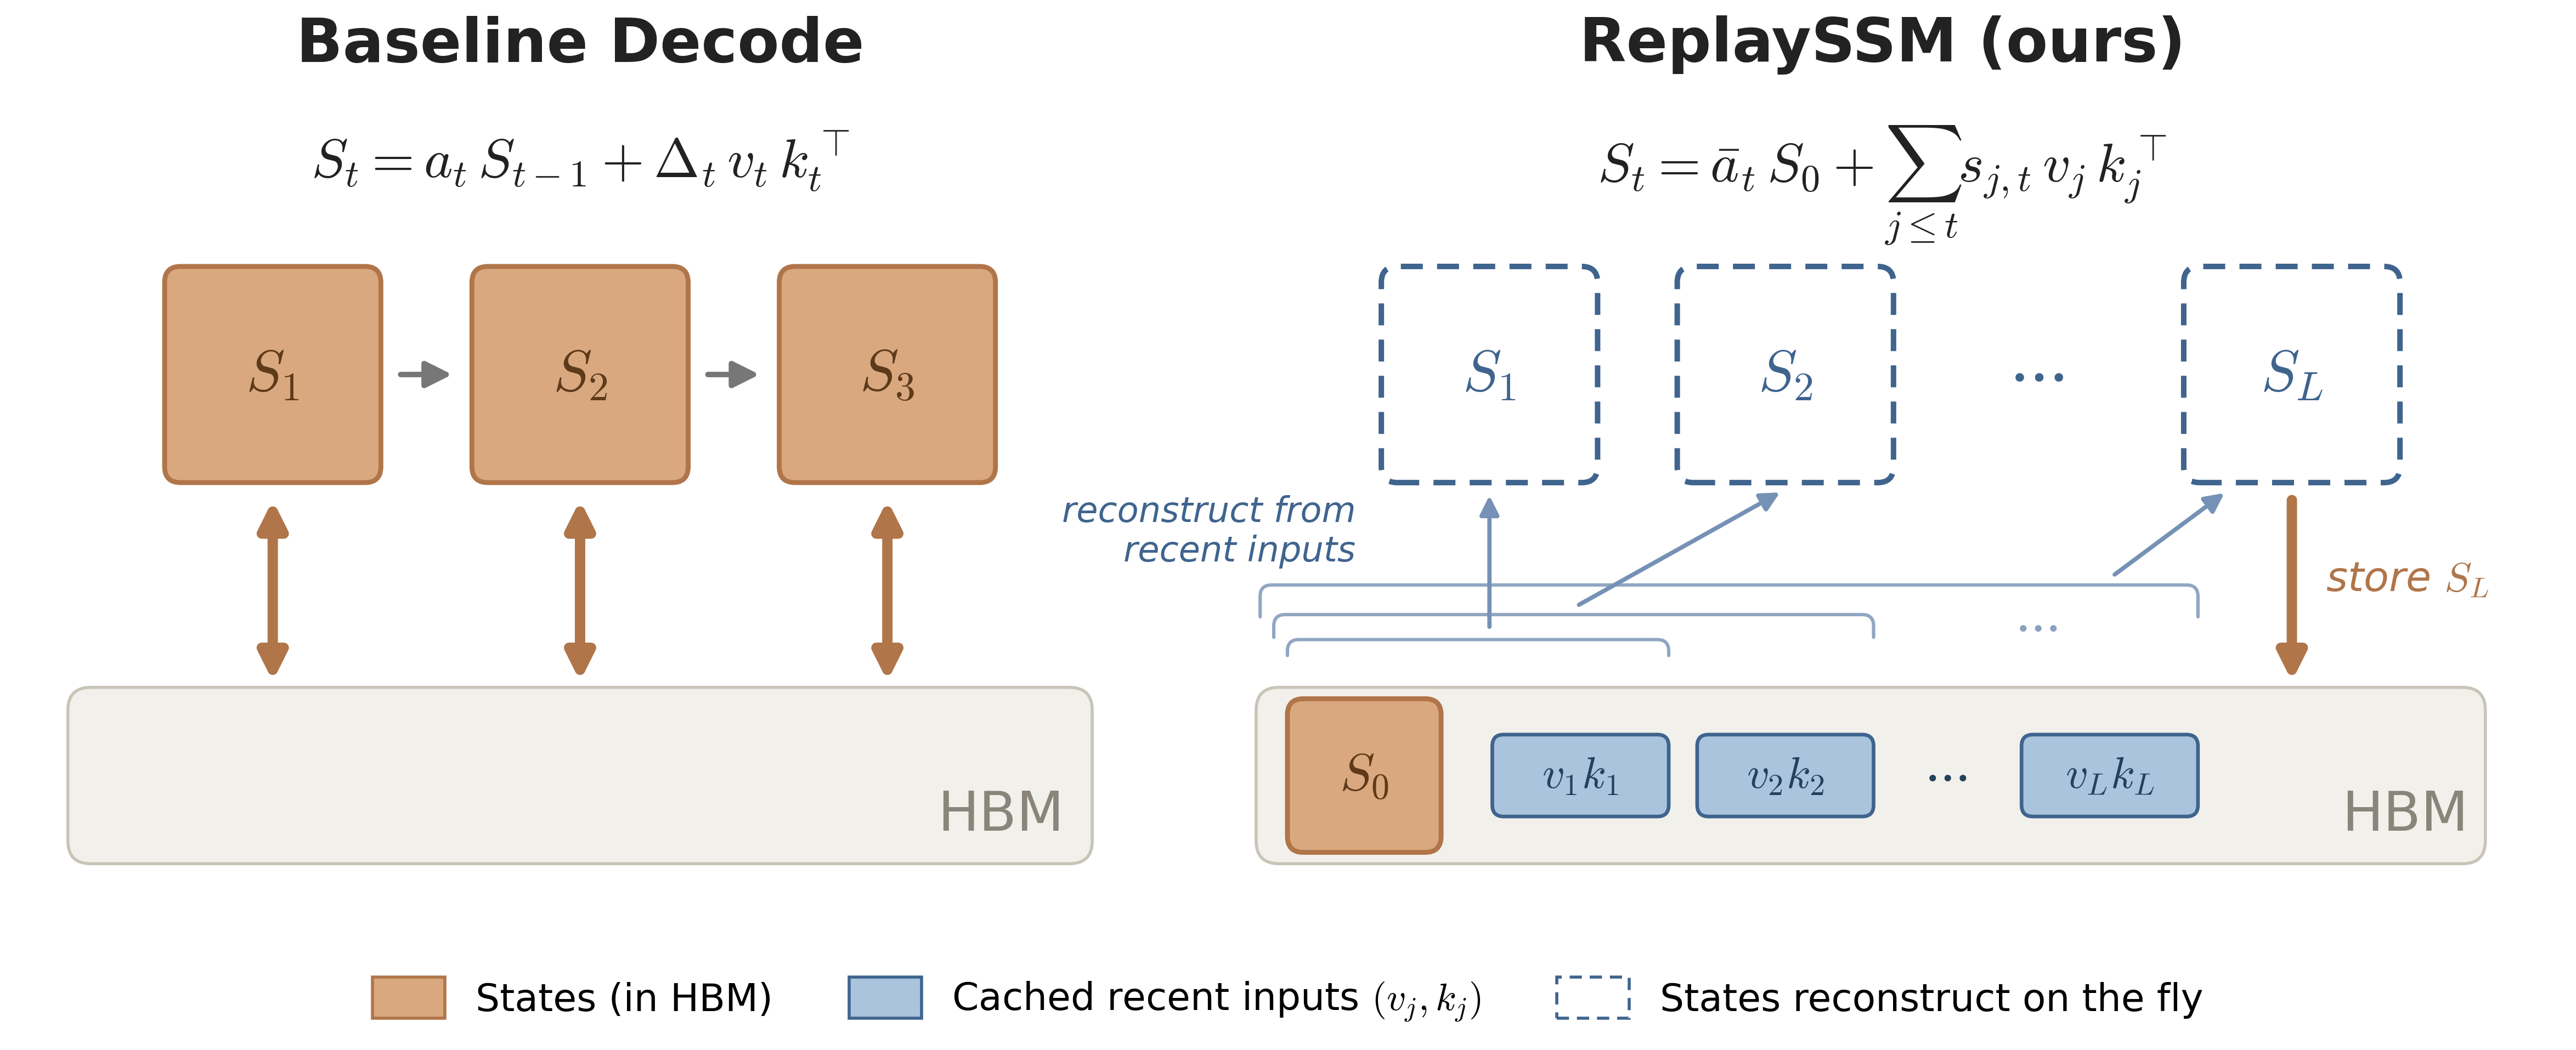
为什么 SSM Decode 仍然很慢
以 Mamba-2 的单头递推为例:
其中
- 内存带宽受限:FP32 状态仅一次读写就产生约
Bytes/Head 的流量。 - 无法直接回滚:历史已压缩进状态;投机 Token 被拒绝时,需要恢复此前保存的状态快照。
- 验证保持串行:验证
个草稿 Token 仍依赖 ,难以转成 GEMM。
状态大小虽然不随上下文增长,但每个 Decode Step 都要搬运这块固定状态。
Checkpoint + History Buffer
ReplaySSM 将运行时状态拆成两部分:
- Checkpoint
:最近一次 Flush 后的完整状态; - History Buffer
:Checkpoint 之后的近期更新输入,Mamba-2 缓存 。
从
同一个状态既可由上一步状态递推得到,也可由 checkpoint 与近期输入重放得到。ReplaySSM 选择后者,因此多数步骤只向 Buffer 追加小向量,不写回完整状态。
Output-only Decode
多数 Decode Step 只需要
输出可直接写为:
该路径先计算标量
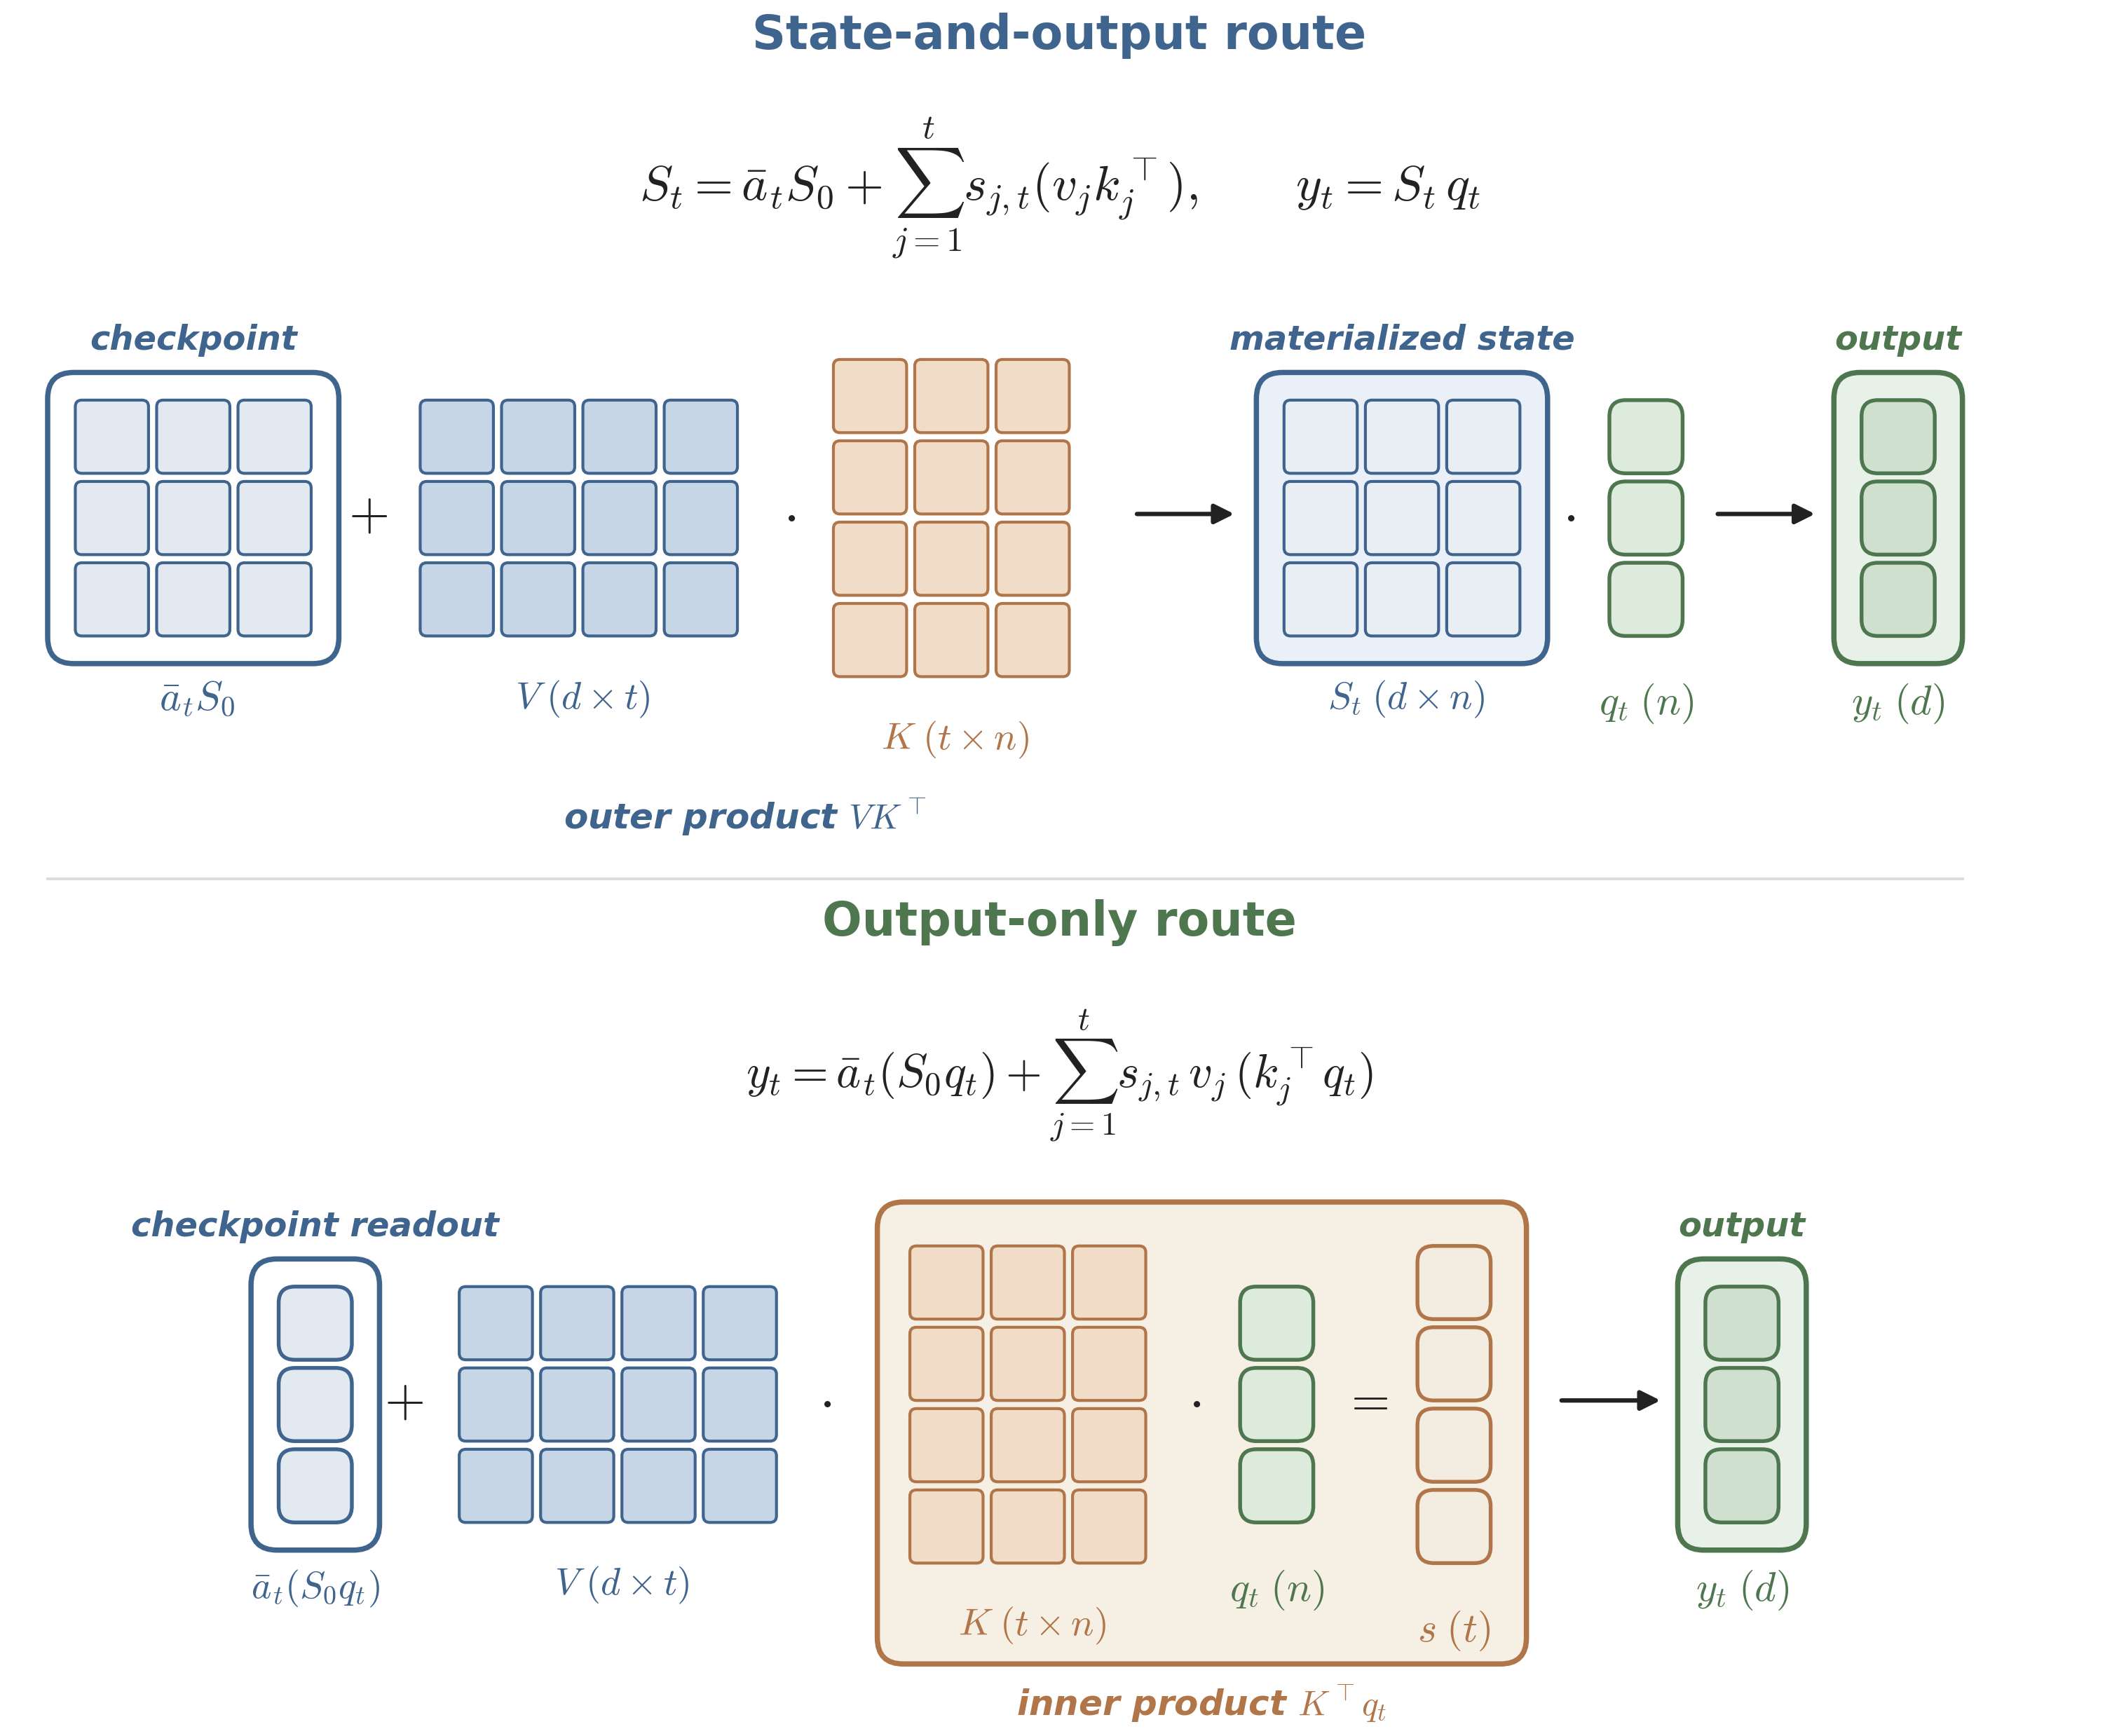
ReplaySSM 在两条路径间切换:
| 路径 | 触发条件 | 操作 |
|---|---|---|
| Non-flush | Buffer 未满 | 读取 |
| Flush | Buffer 已满或需要完整快照 | 将 Buffer 折叠进 |
忽略较小的 Buffer 流量,主导状态流量从每步约
投机解码
标准 SSM 投机解码需要为每个草稿位置保存完整状态。ReplaySSM 只保存一个 checkpoint 和近期输入;草稿被拒绝时移动 Buffer 指针即可,无须恢复状态快照。
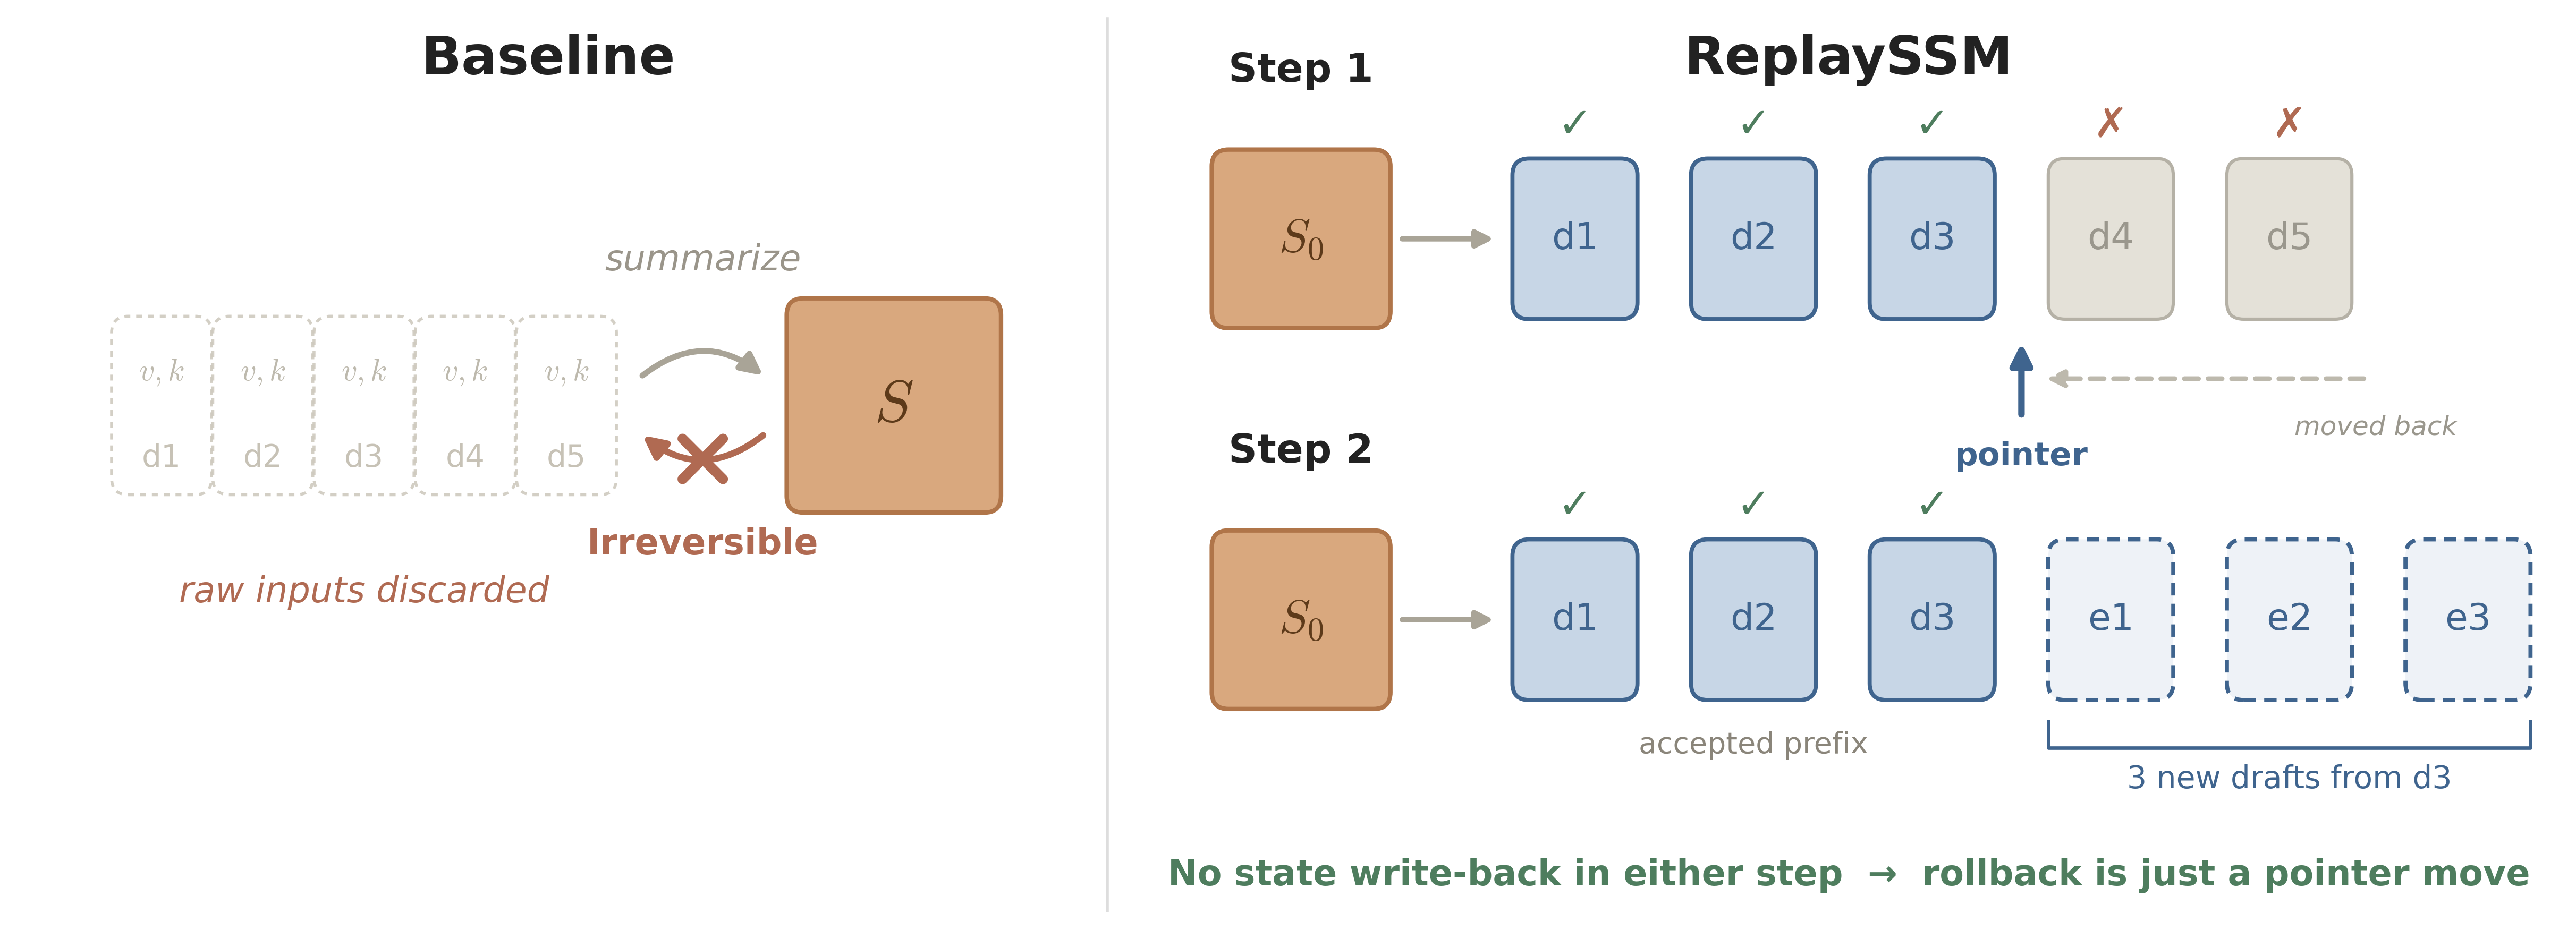
对 Mamba-2,所有草稿位置共享
Gated DeltaNet(GDN)还需缓存依赖旧状态的修正向量
效果与适用边界
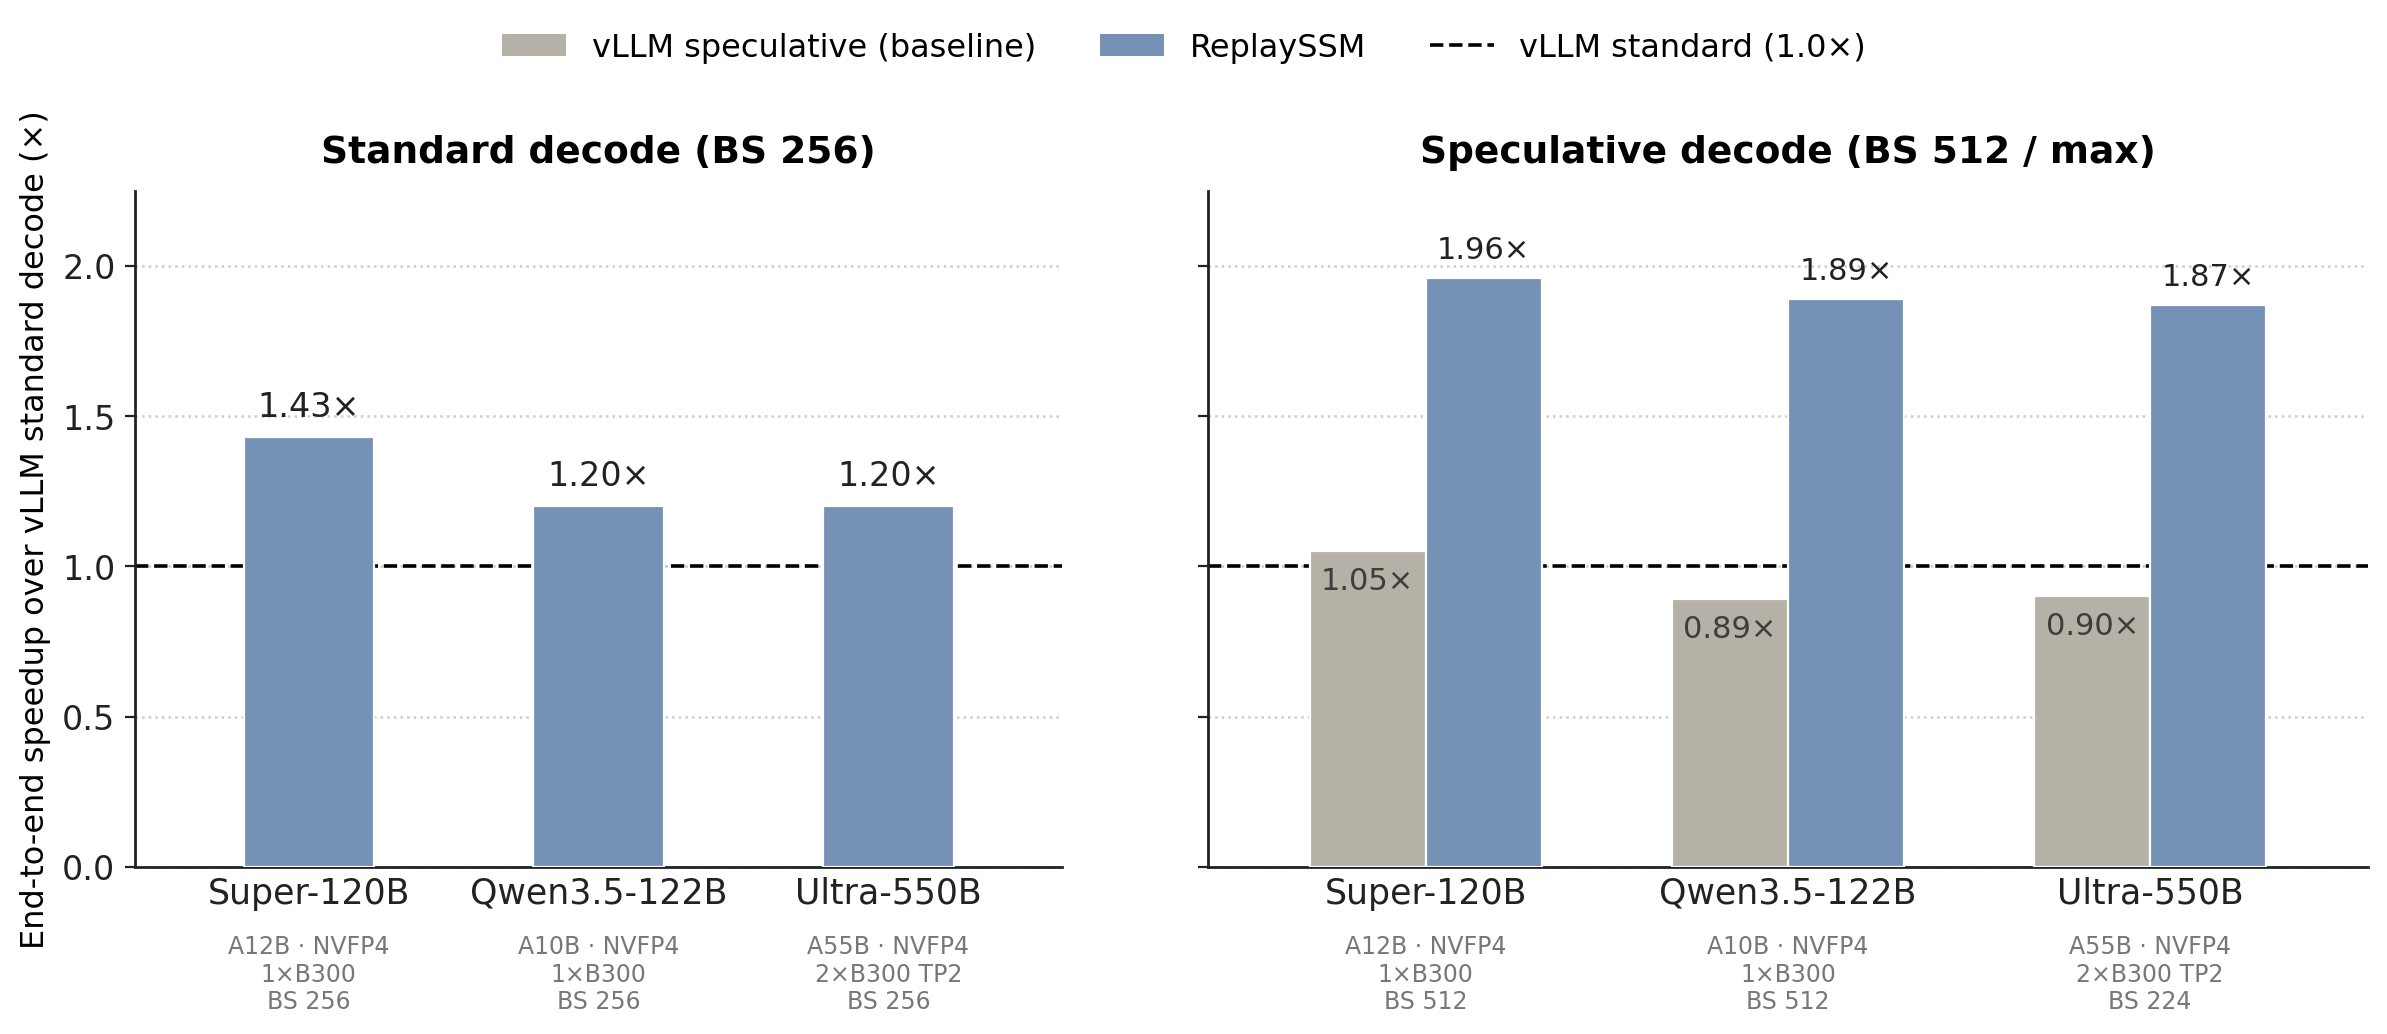
原文在 vLLM + CUDA Graph 上测试多种 Nemotron-3 与 Qwen3.5 模型:标准 Decode 端到端最高提升 1.48×,图中的大规模 MoE 模型最高为 1.43×;投机 Decode 相对标准 Decode 达到 1.87–1.96×。图中模型使用 NVFP4,并在 B300、较大 Batch 下测试。
这些结果依赖工作负载:
- ReplaySSM 主要优化 SSM/线性注意力层,不减少 Attention、MLP、通信和采样开销。
- 小 Batch 可能受 Kernel Launch 或其他层限制,收益会明显降低。
- Buffer 太短会频繁 Flush,太长会增加缓存读取和重放计算。
- 重放改变浮点归约顺序;数学等价不代表逐 Bit 一致,仍需验证状态误差与最终输出。
ReplaySSM 的核心取舍是:用近期输入的小缓存和少量重计算,换取完整状态写回次数的下降。它尤其适合大 Batch、SSM Kernel 已受 HBM 带宽限制,或投机解码受状态快照和串行验证约束的场景。