ReplaySSM
ReplaySSM 将循环状态表示为一个完整检查点和一段近期更新缓存,使 Decode 在多数步骤只写入小向量,按需合并并写回完整状态。本文以 SGLang 的 Gated DeltaNet(GDN)实现为主线,说明状态重放、Flush、前缀缓存与 CUDA Graph 的协作方式。
源码基于本地 SGLang 提交 0b3bb0cbe31873994c9f989fddfe2f87ca839fdd。下文的参数、缓存布局和支持范围均对应这一版本。
1. Decode 状态开销
GDN 将历史信息压缩进固定大小的循环状态。对一个 Value 头,设状态为
其中,d_cache;公式中的
常规 Decode 每步读取
例如
2. 检查点与更新缓存
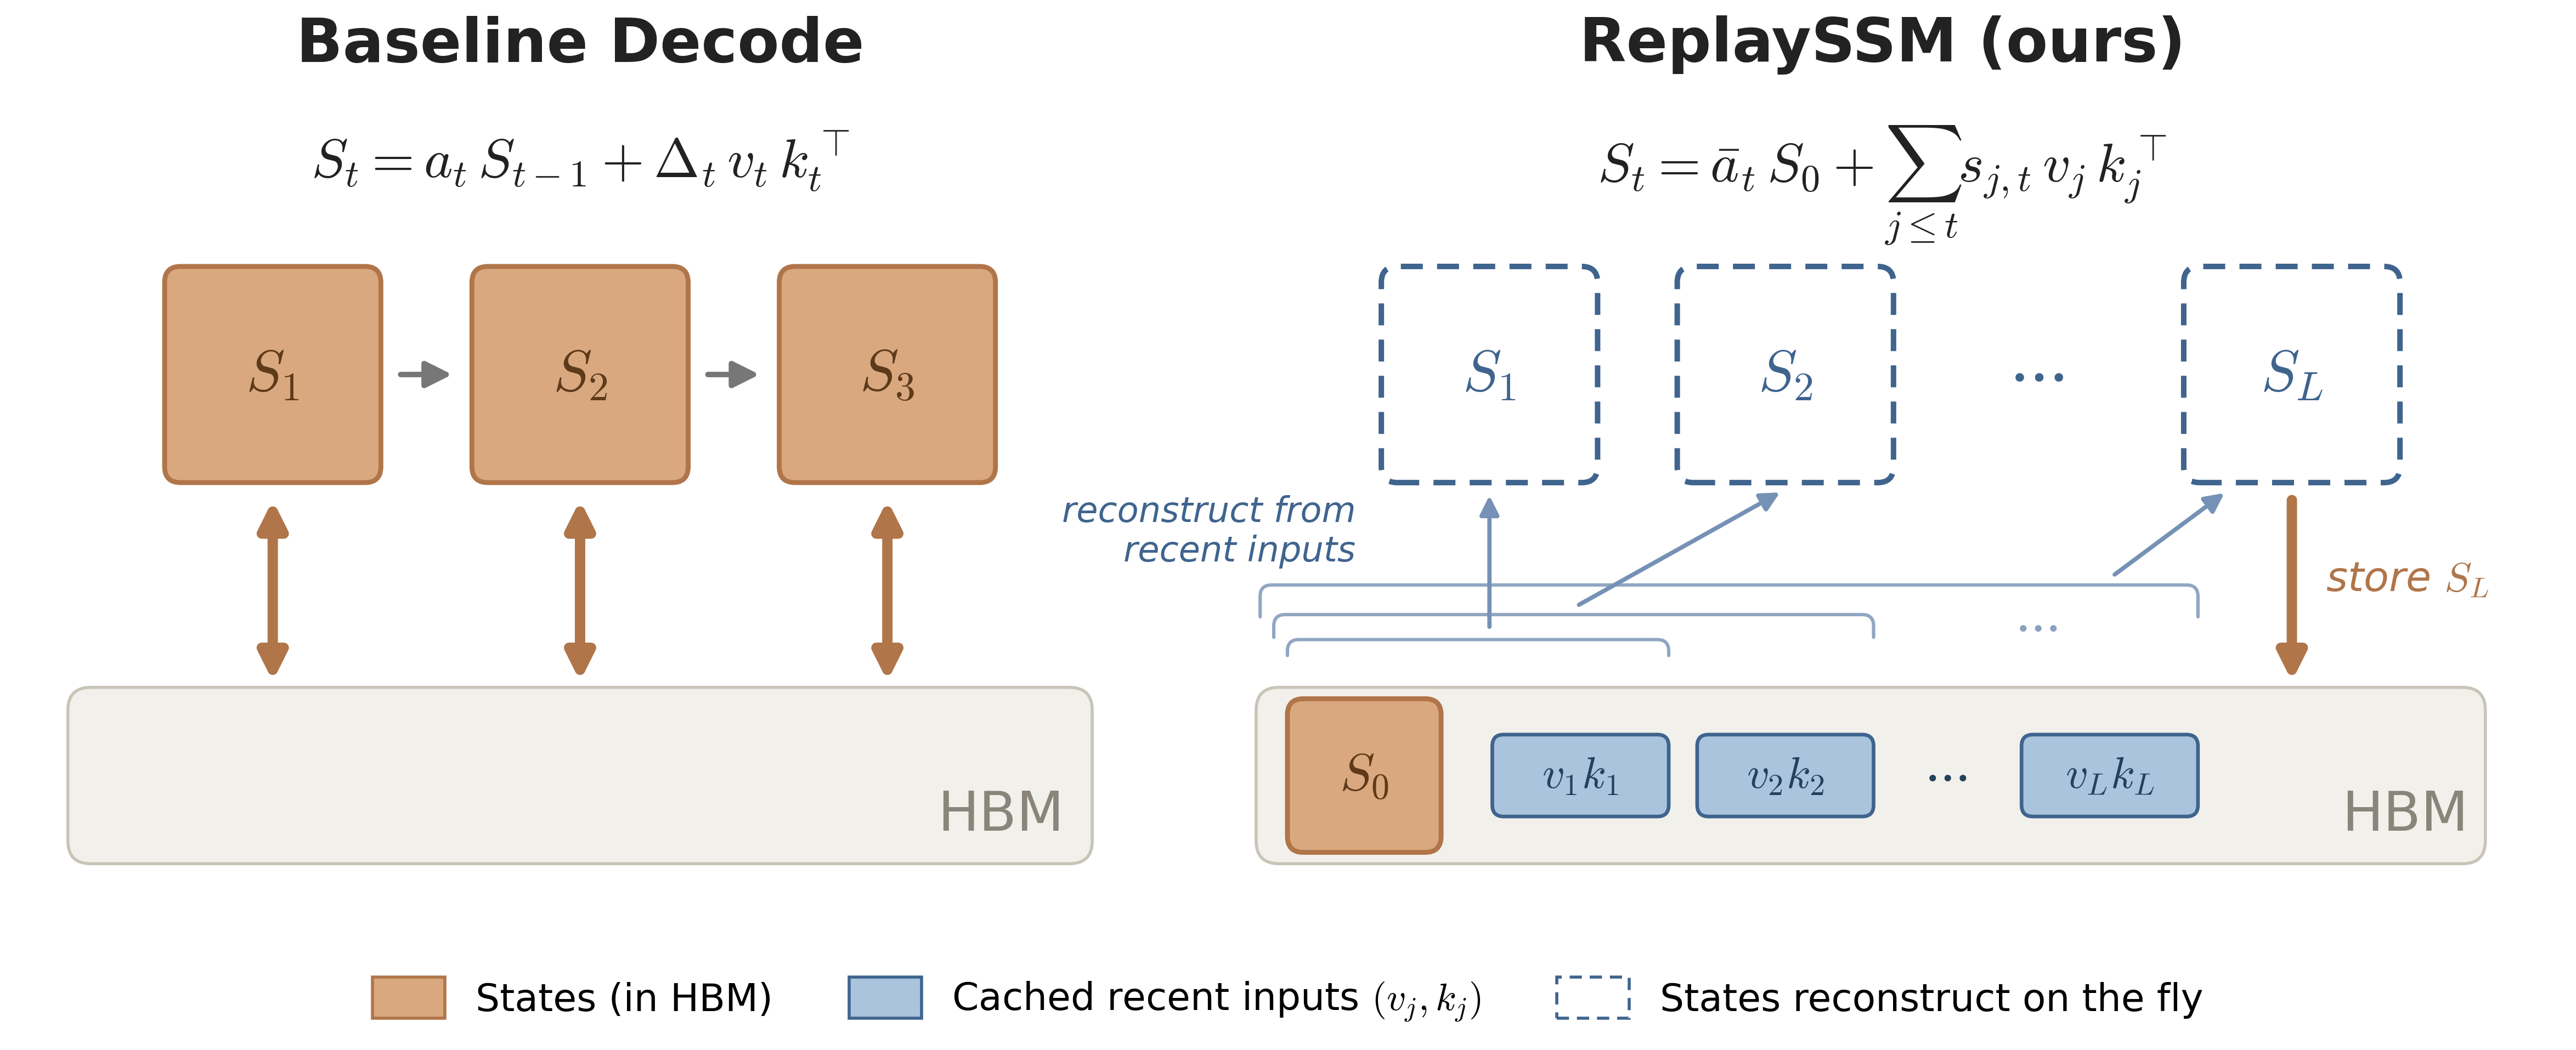
图 1:检查点与近期更新缓存。引自官方文章图 1a。图中以 Mamba-2 的
2.1 状态重放
设最近一次完整写回的状态为
空乘积取 1。因此,只要保存
SGLang 在每个 Decode 步骤读取检查点和有效缓存,计算当前输出;只有 Flush 步骤将完整新状态写回 HBM。Flush 后缓存逻辑长度归零,后续步骤从新检查点继续。
2.2 缓存布局
以下形状均省略最外层的模型层维度。
| 张量 | 形状 | 内容 |
|---|---|---|
temporal | [N, H_v, d_v, d_k] | 完整状态检查点 |
replayssm_d | [N, H_v, L, d_v] | 历史修正向量 |
replayssm_k | [N, H_k, L, d_k] | 历史 Key,同组 Value 头共享 |
replayssm_g | [N, H_v, L] | GDN 的历史对数衰减门 |
replayssm_write_pos | [N] | 有效记录数和下一写入位置 |
MambaPool 按 ssm_dtype 分配 d、k 缓存,g 使用 FP32。每层拥有自己的更新缓存;槽位游标跨线性注意力层共享,每次 Forward 统一推进一次。源码:缓存分配
因此,ReplaySSM 在普通 Decode 下增加了近期缓存的显存占用,主要收益是减少状态写回流量。它仍保留完整检查点,也仍然需要读取该检查点。
3. SGLang 执行流程
3.1 后端分派
GDN 的 Decode 路径先更新因果卷积,再把卷积后的打包 QKV、门控输入、状态槽位和 ReplaySSM 缓存交给 Triton 后端:
HybridLinearAttnBackend:读取槽位游标,生成 Flush 标记
  → GDNBackend.forward_decode:更新 Conv State,取得本层缓存
  → Triton GDN decode:检查更新缓存与游标是否齐备
  → fused_recurrent_gdn_replayssm_decode
  → fused_recurrent_linear_replayssm_decode_kernel
  → 输出;按需写回状态;保存前缀状态快照
打包输入 mixed_qkv 的形状为 [B, 2*H_k*d_k + H_v*d_v],ssm_state_indices 映射到物理状态槽位,不能将批内行号直接当作槽位号。填充行使用负槽位索引,内核写出零并返回。
只有 d、k、g 缓存和游标全部存在时,GDN Triton 后端才调用 ReplaySSM;否则使用常规 Packed Decode。源码:Decode 分派
3.2 非 Flush 步骤
内核先根据缓存的
随后直接计算:
这里的结合律避免了为了输出再生成完整
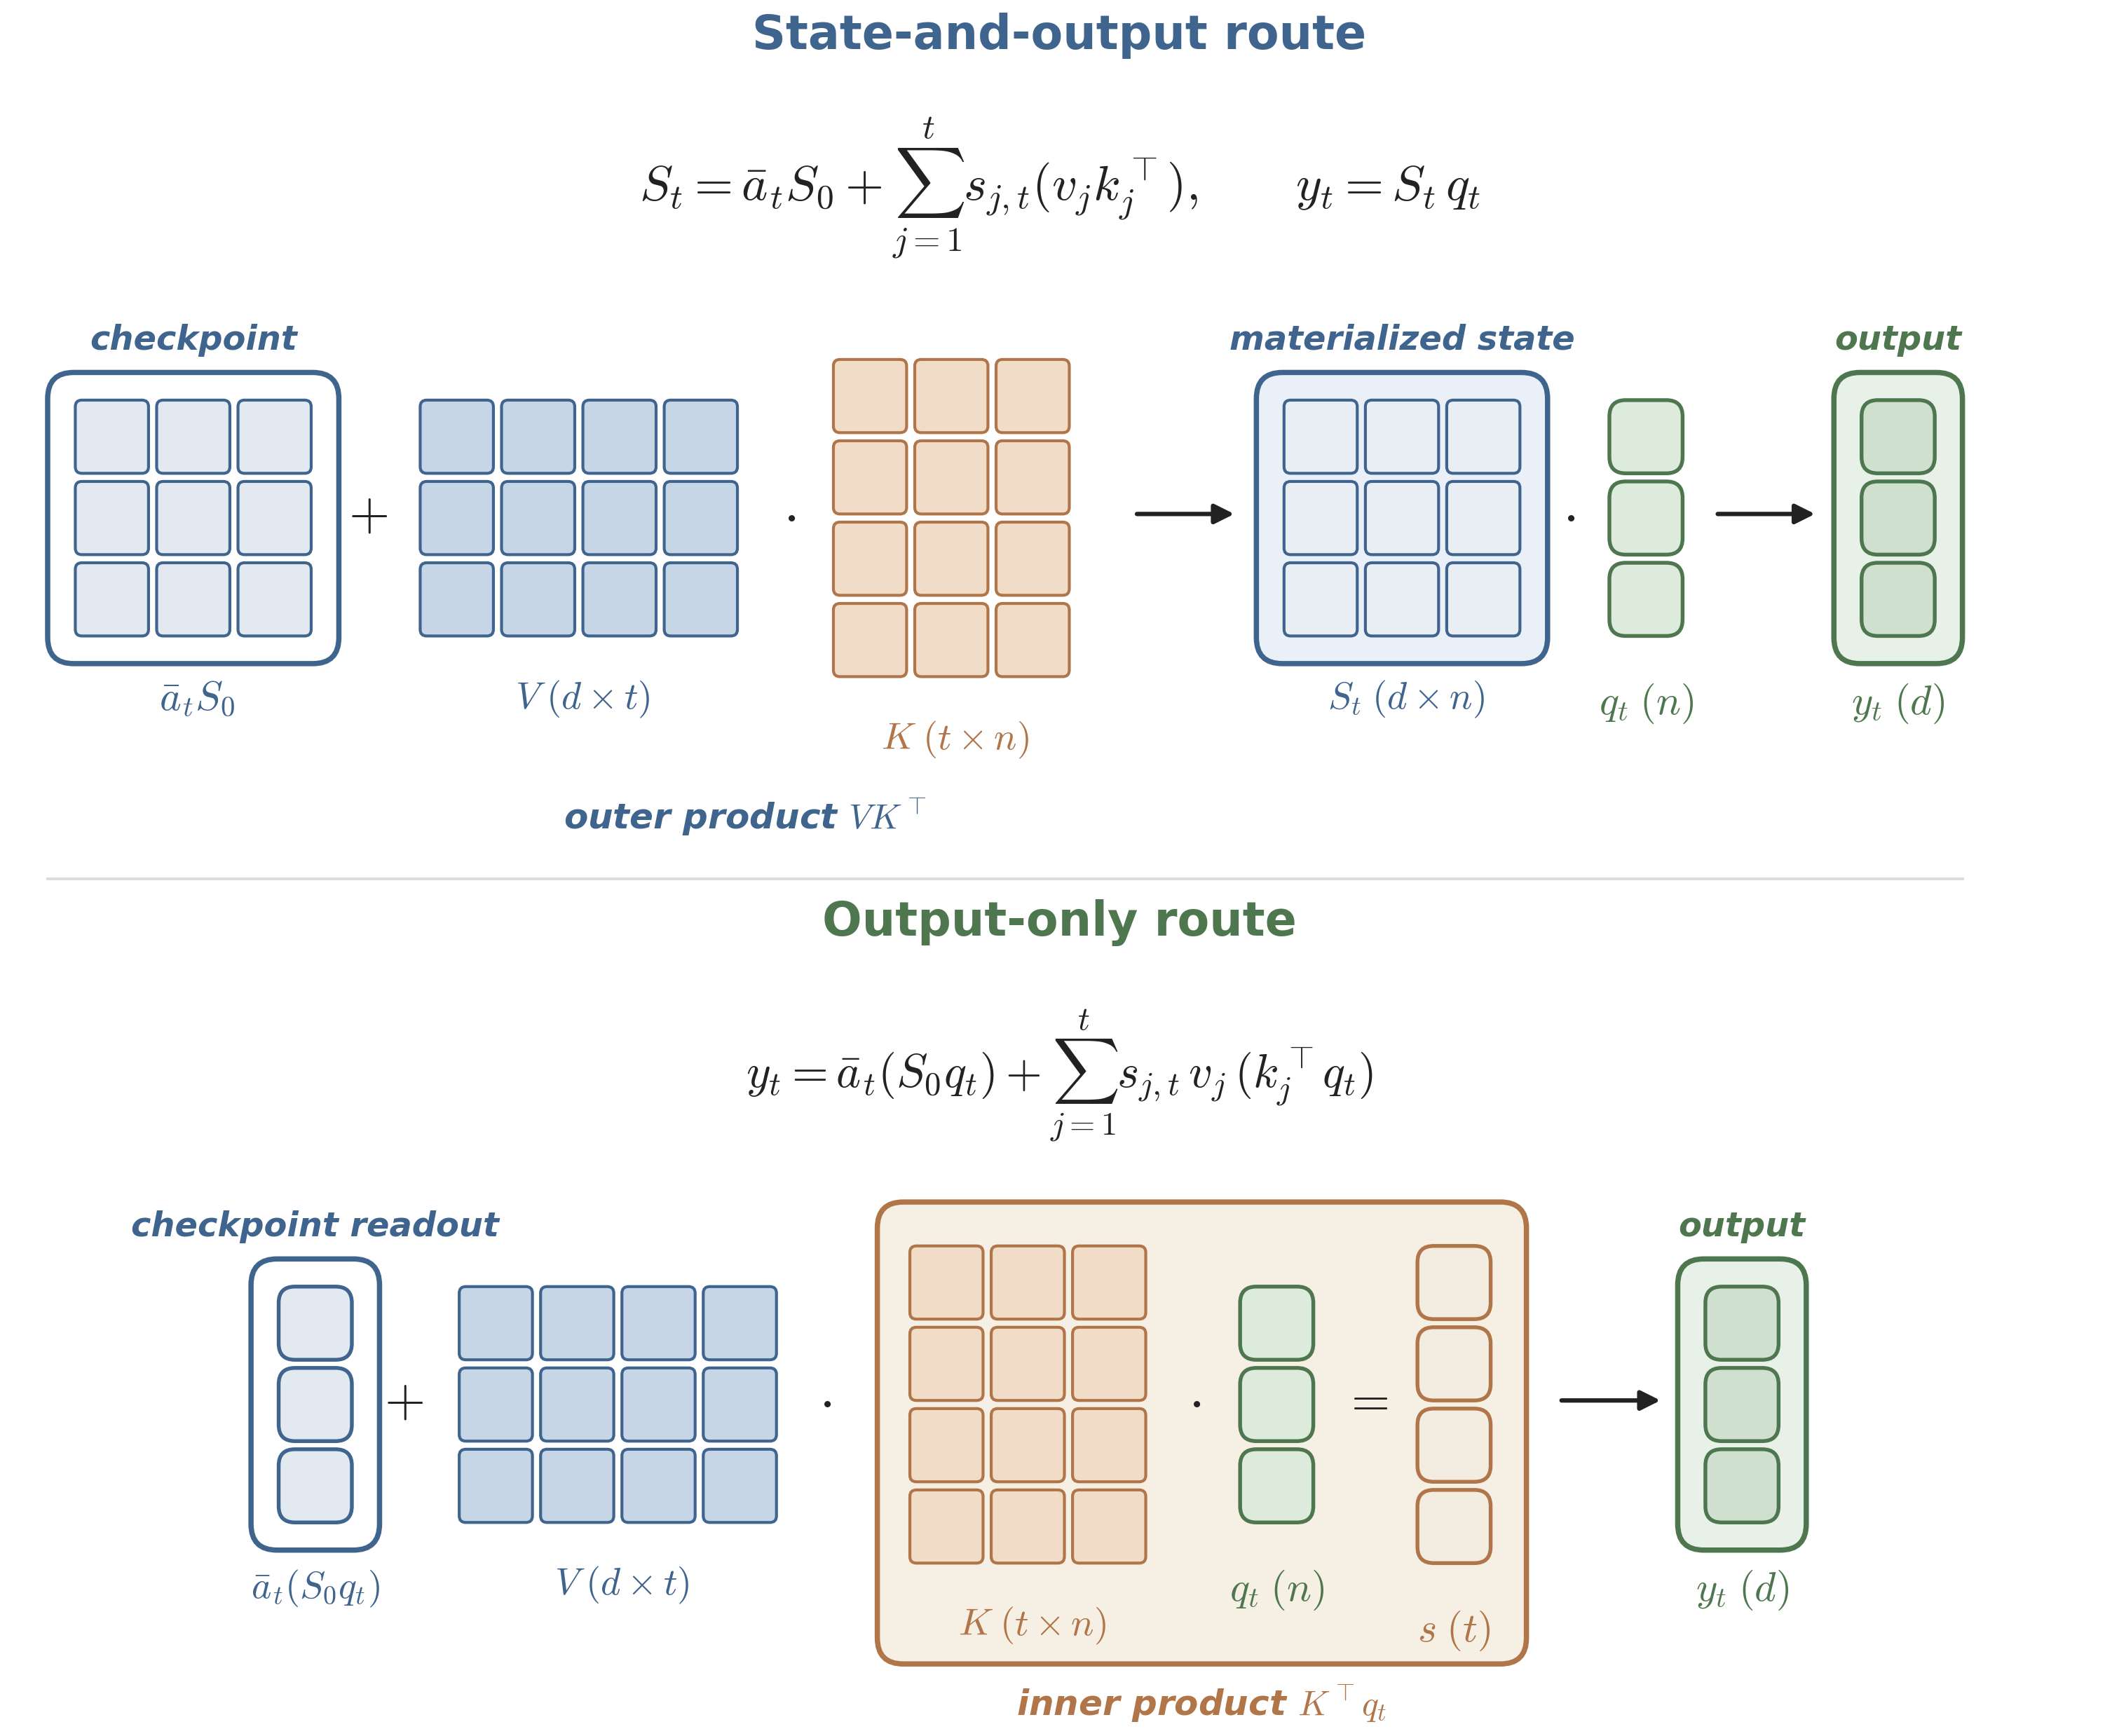
图 2:State-and-output 与 Output-only 的计算顺序。引自官方文章图 5b,展示 Mamba-2 的两条路径;SGLang GDN 的状态分块重建与双重读出见下方源码。
📄 fused_recurrent_linear_replayssm.py:GDN 状态读出
# b_h0_c: [BV, BKT] 检查点分块
# b_d_tc: [BV, BC] 带历史衰减的修正向量
# b_k_all_c: [BC, BKT] 历史 Key 分块
# BV、BKT、BC 分别是 Value、Key、缓存长度的计算块大小。
b_h_c = b_h0_c * b_total_decay + tl.dot(b_d_tc, b_k_all_c).to(tl.float32)
...
b_state_q += tl.sum(b_h_c * q_eff[None, :], axis=1)
b_state_k += tl.sum(b_h_c * k_eff[None, :], axis=1)
...
if not IS_KDA:
    b_state_q *= alpha_val
    b_state_k *= alpha_val
b_d_cur = beta_val * (b_v - b_state_k)
b_o = b_state_q + b_d_cur * tl.sum(cur_kq)
tl.store(p_o, b_o.to(p_o.dtype.element_ty), mask=mask_v)
非 Flush 步骤把当前 tl.dot 使用转换到输出数据类型的操作数,以利用 Tensor Core;因此数学等价并不意味着浮点结果逐位一致。
3.3 Flush 步骤
自然 Flush 条件是 write_pos == L - 1:已有 force_flush 提前触发。
Flush 步骤先计算当前修正和输出,再次遍历 Key 分块,重建旧状态并执行:
完整新状态写回后,下一步游标设为零。旧缓存数据无须物理清零,因为后续读取只允许访问 position < write_pos 的有效记录。源码:Flush 分支
以
| 当前步骤 | 步前检查点 | 步前有效缓存 | 步后操作 |
|---|---|---|---|
| 1 | 空 | 缓存第 1 条更新 | |
| 2 | 1 | 缓存第 2 条更新 | |
| 3 | 1、2 | 缓存第 3 条更新 | |
| 4 | 1、2、3 | 写回 | |
| 5 | 空 | 缓存第 5 条更新 |
当
4. 缓存与调度协作
4.1 前缀状态快照
非 Flush 步骤中的 temporal 只代表检查点位置,最新状态还包含更新缓存。如果直接把它作为当前前缀的完整快照,就会遗漏尚未合并的 token。
SGLang 对 GDN 在 seq_lens % mamba_track_interval == 0 的跟踪边界设置 force_flush,让状态写回与快照保存对齐。复制状态的 MambaPool.copy_from 要求源槽位已经 Flush,并将目标槽位游标归零;新分配或复用的槽位也从空缓存开始。源码:边界判定、源码:状态复制
这也说明 Flush 周期不一定始终等于
4.2 CUDA Graph
同一个 Batch 中,不同请求的缓存长度和 Flush 时机可能不同。内核通过逐行游标和 Flush 标记在设备侧选择分支,CUDA Graph 可以复用相同的启动结构。
HybridLinearAttnBackend 为 Graph 准备固定地址的游标和强制 Flush 缓冲区,每次 Replay 原地更新内容,再交给各层读取。这里 CUDA Graph 的 Replay 是重放 GPU 执行图,ReplaySSM 的 Replay 是从更新缓存重建状态,二者处理不同层次的问题。源码:Graph 元数据
5. 开销与适用范围
5.1 带宽与重计算
假设 FP32 状态、每
相对于基线
SGLang 的 Flush 分支会再次读取检查点并重建状态。若第二次读取也全部落到 HBM,且仍忽略更新缓存,均摊状态流量应计为
增大
5.2 KDA 与投机解码
统一内核通过 IS_KDA 支持 Kimi Delta Attention(KDA)。KDA 的衰减门沿 Key 通道变化,其状态衰减为 g_cache 形状变为 [N, H_v, L, d_k]。相较 GDN,门缓存大了
从算法上,缓存近期更新还可用于丢弃未接受草稿,减少投机解码中的完整状态快照;前提是未确认更新不能合并进检查点。ReplaySSM 原文展示了这一扩展,但本文所核对的 SGLang 接入位于单 token Decode 路径,GDN 的 forward_extend 中仍有独立的 Target Verify 分支,不能将启用此开关视为已使用原文的整段投机验证算法。ReplaySSM 原文、源码:GDN 后端
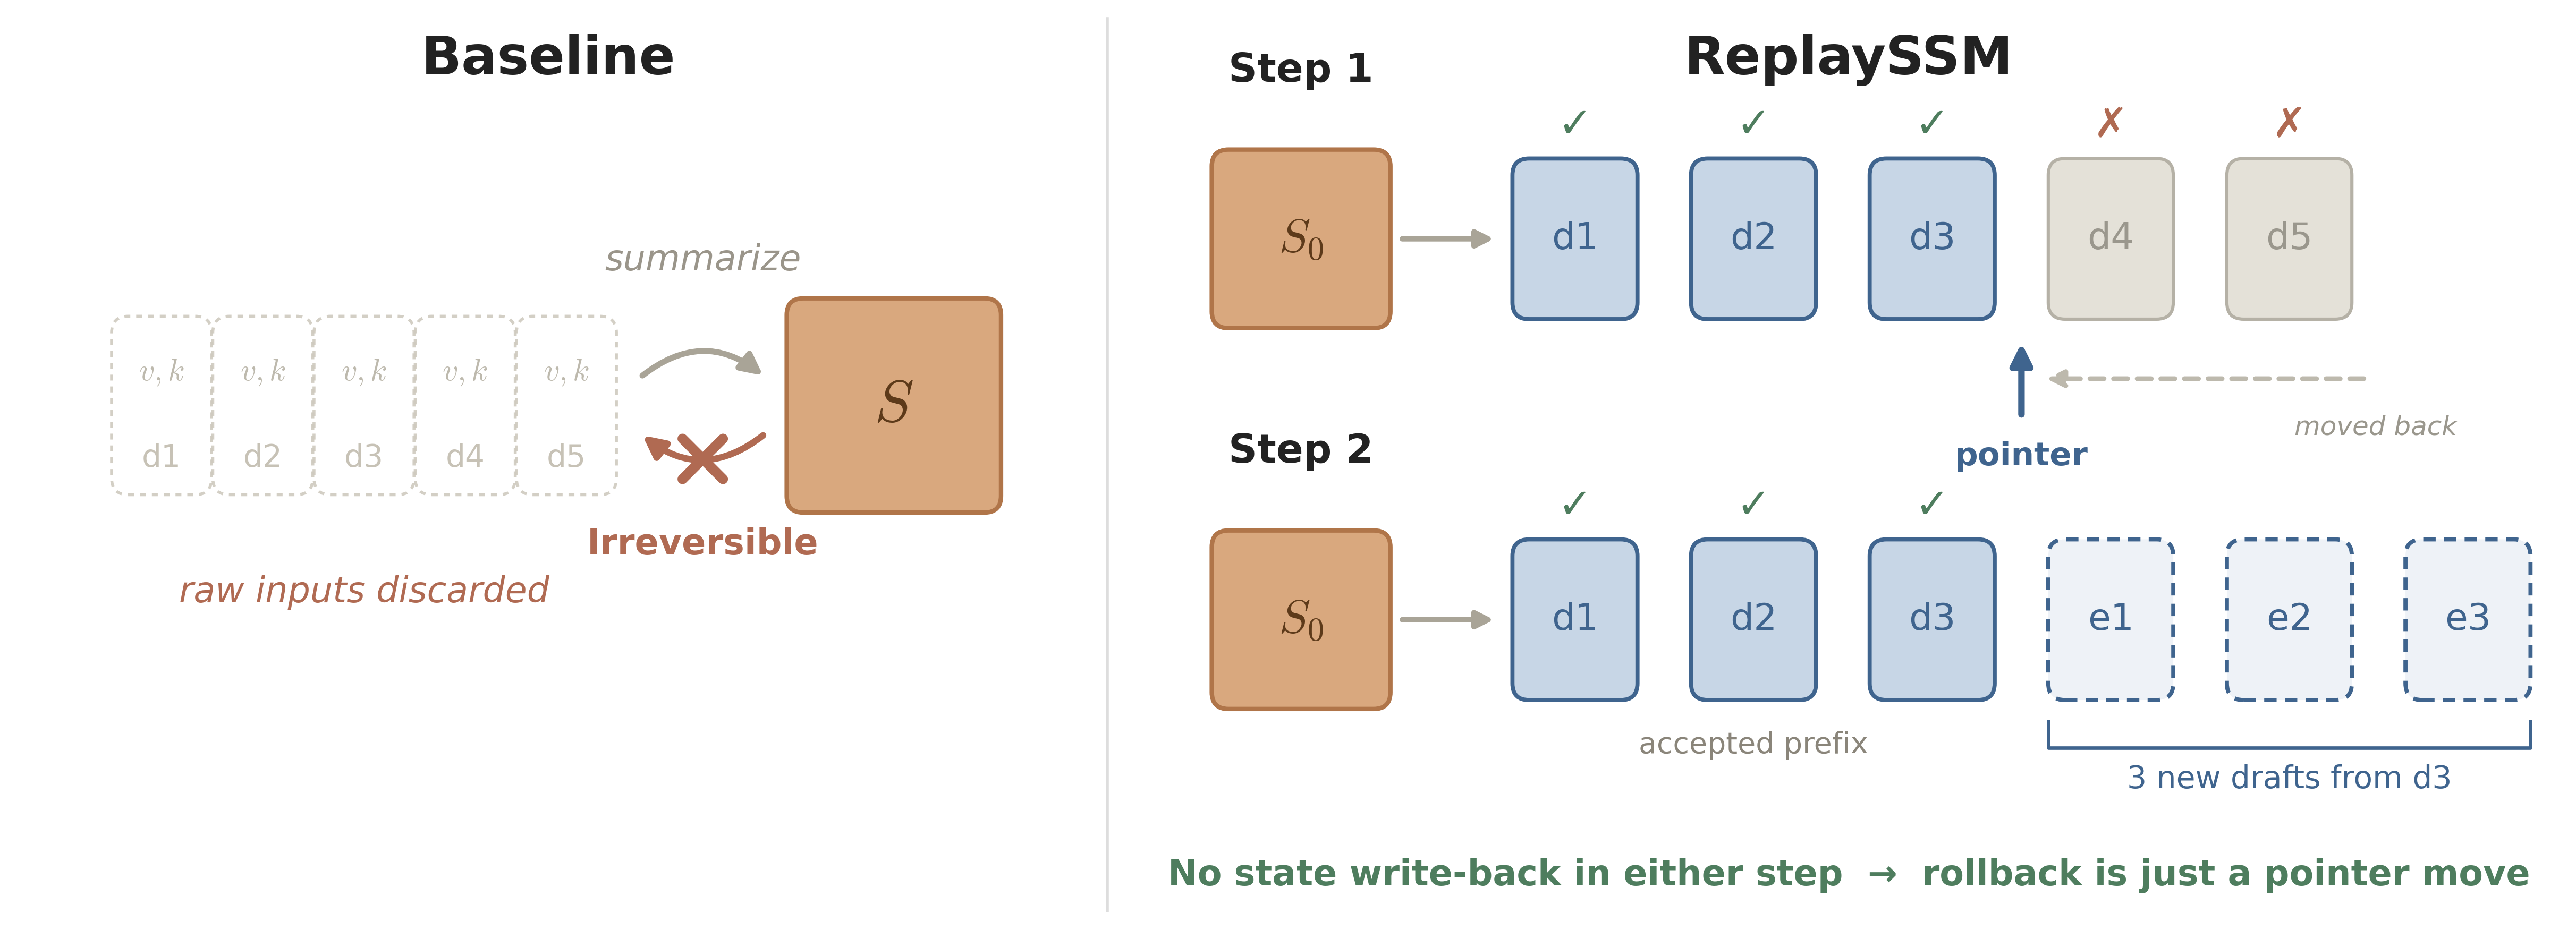
图 3:投机回滚的算法示意。引自官方文章图 4。图中的 d1~d5 表示草稿位置,不是本文 d_cache 的修正向量;该图描述原文算法的扩展能力。
6. 配置与验证
6.1 启用配置
对使用 GDN 的模型,可在该版本中使用以下参数组合;/path/to/gdn-model 替换为实际模型目录:
python -m sglang.launch_server \
  --model-path /path/to/gdn-model \
  --linear-attn-decode-backend triton \
  --enable-linear-replayssm \
  --linear-replayssm-cache-len 16 \
  --mamba-scheduler-strategy no_buffer
该开关默认关闭,缓存容量默认 16,要求容量至少为 1。参数校验要求 Triton Linear Attention Decode 后端及 no_buffer 调度策略,并拒绝 PD 分离模式;支持范围以对应提交的参数校验为准。源码:配置约束
6.2 正确性与性能
仓库的 test_linear_replayssm_decode.py 对 GDN、KDA 分别运行 FP32 和 BF16 多步对比,覆盖
在安装好该 SGLang 版本、PyTorch 和 Triton 的 CUDA 环境中,可从 SGLang 仓库根目录运行:
python test/registered/attention/unittests/gdn/test_linear_replayssm_decode.py
python -m sglang.srt.layers.attention.fla.bench_gdn_replayssm_decode
前者检查数值一致性,后者对比 GDN 内核延迟。端到端评估还应固定模型、输入输出长度和并发数,比较开关前后的吞吐、每 token 延迟与显存占用。本文核对了源码和测试覆盖范围,未执行 GPU 基准,因此不提供 SGLang 的实测加速倍数。
6.3 官方实验
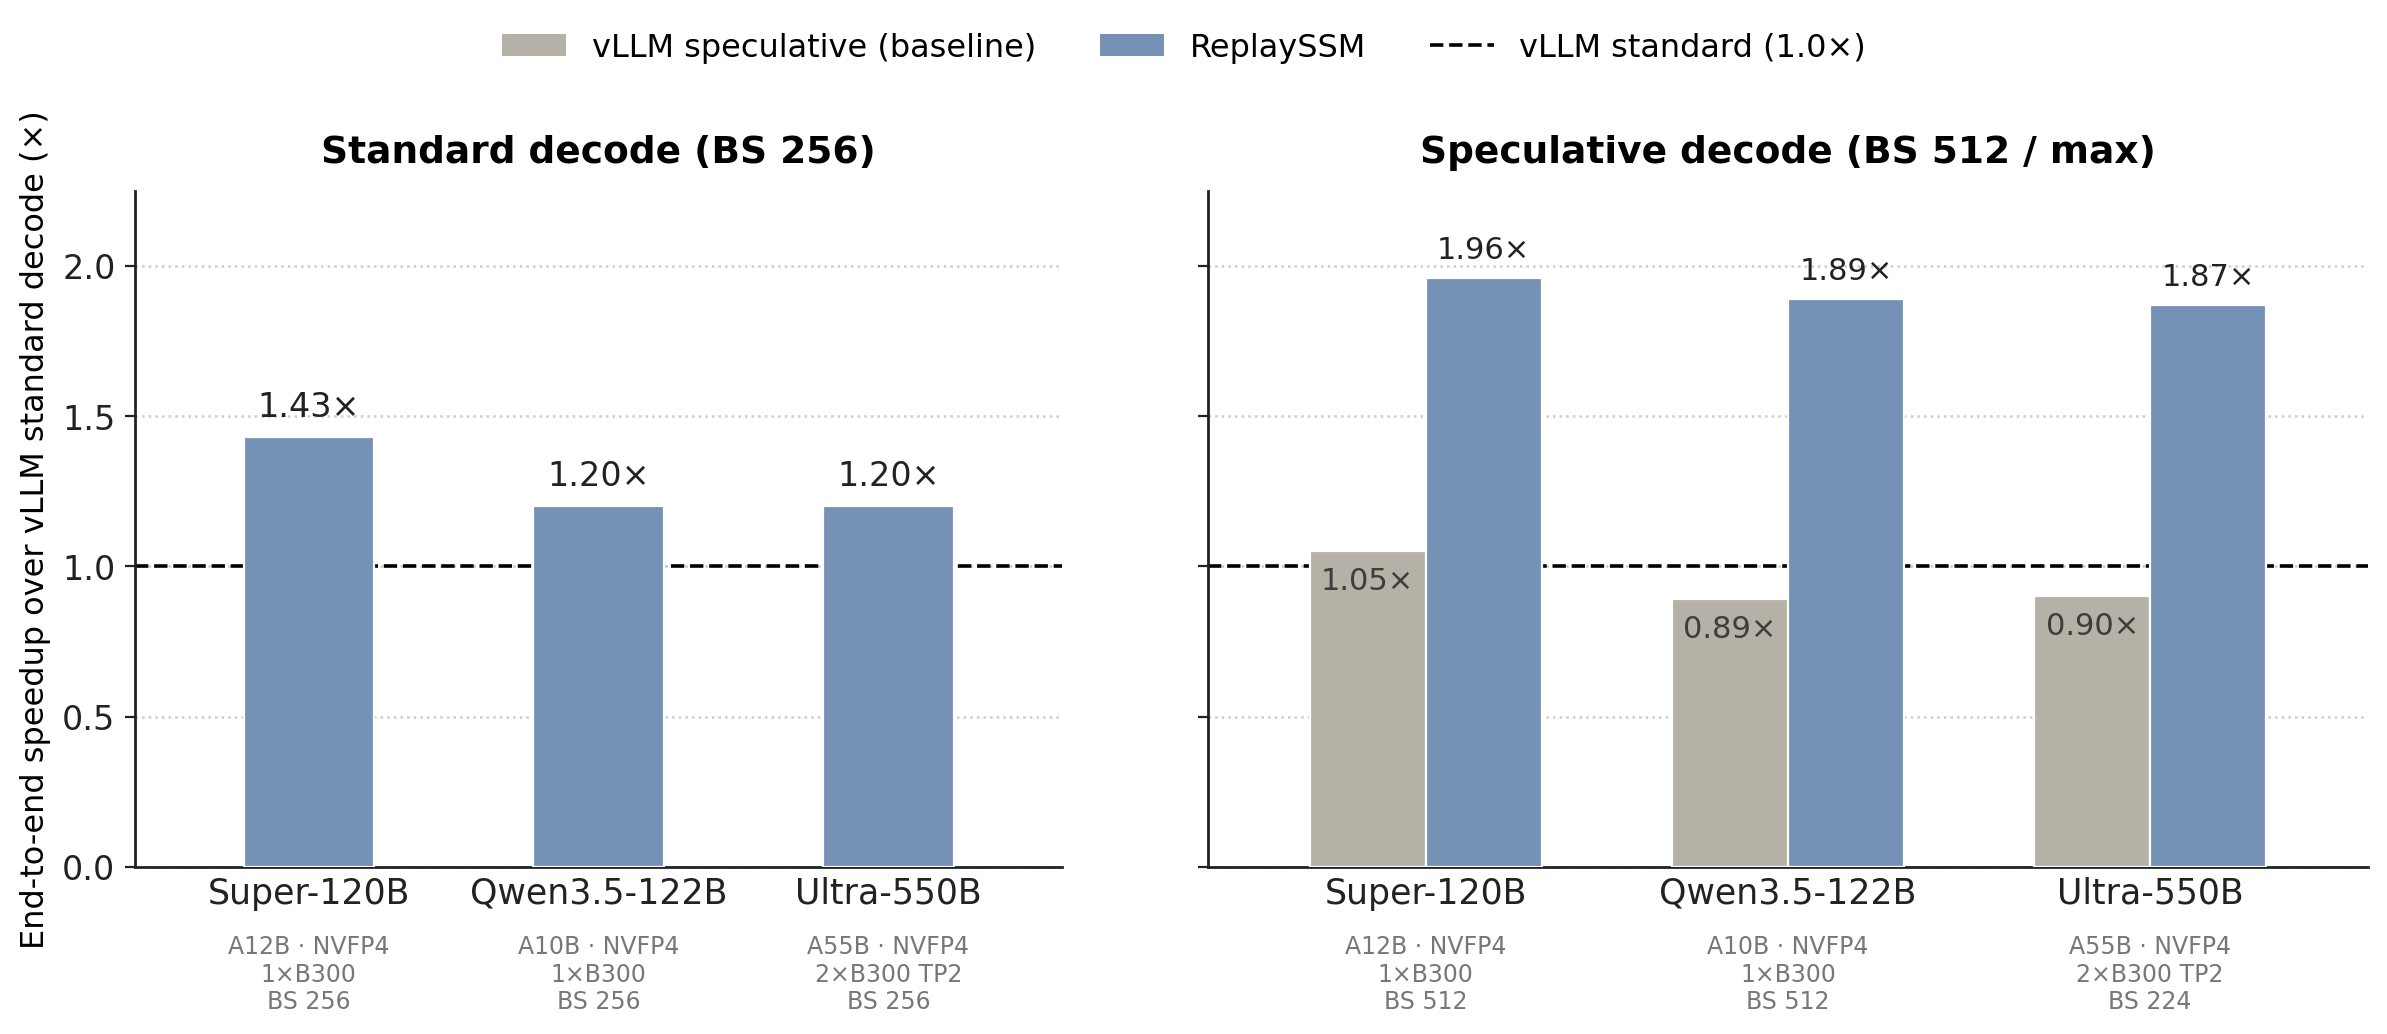
图 4:引自官方文章图 1b。实验使用 vLLM、CUDA Graph、NVFP4 模型和 B300,投机窗口为 4;纵轴统一相对 vLLM 普通解码归一化。图中普通解码最高为 1.43×,投机解码为 1.87~1.96×,作为原文实验结果参考,不代表本文 SGLang 版本的实测收益。