Output
Decoder-only Causal LM 的 Decoder 输出是隐藏状态,而不是文本。模型还需依次完成最终归一化、LM Head 投影、logits 处理、token 选择与反分词,才能得到可读文本;本文以 Qwen2 和 Hugging Face Transformers 为参考实现说明这一流程。
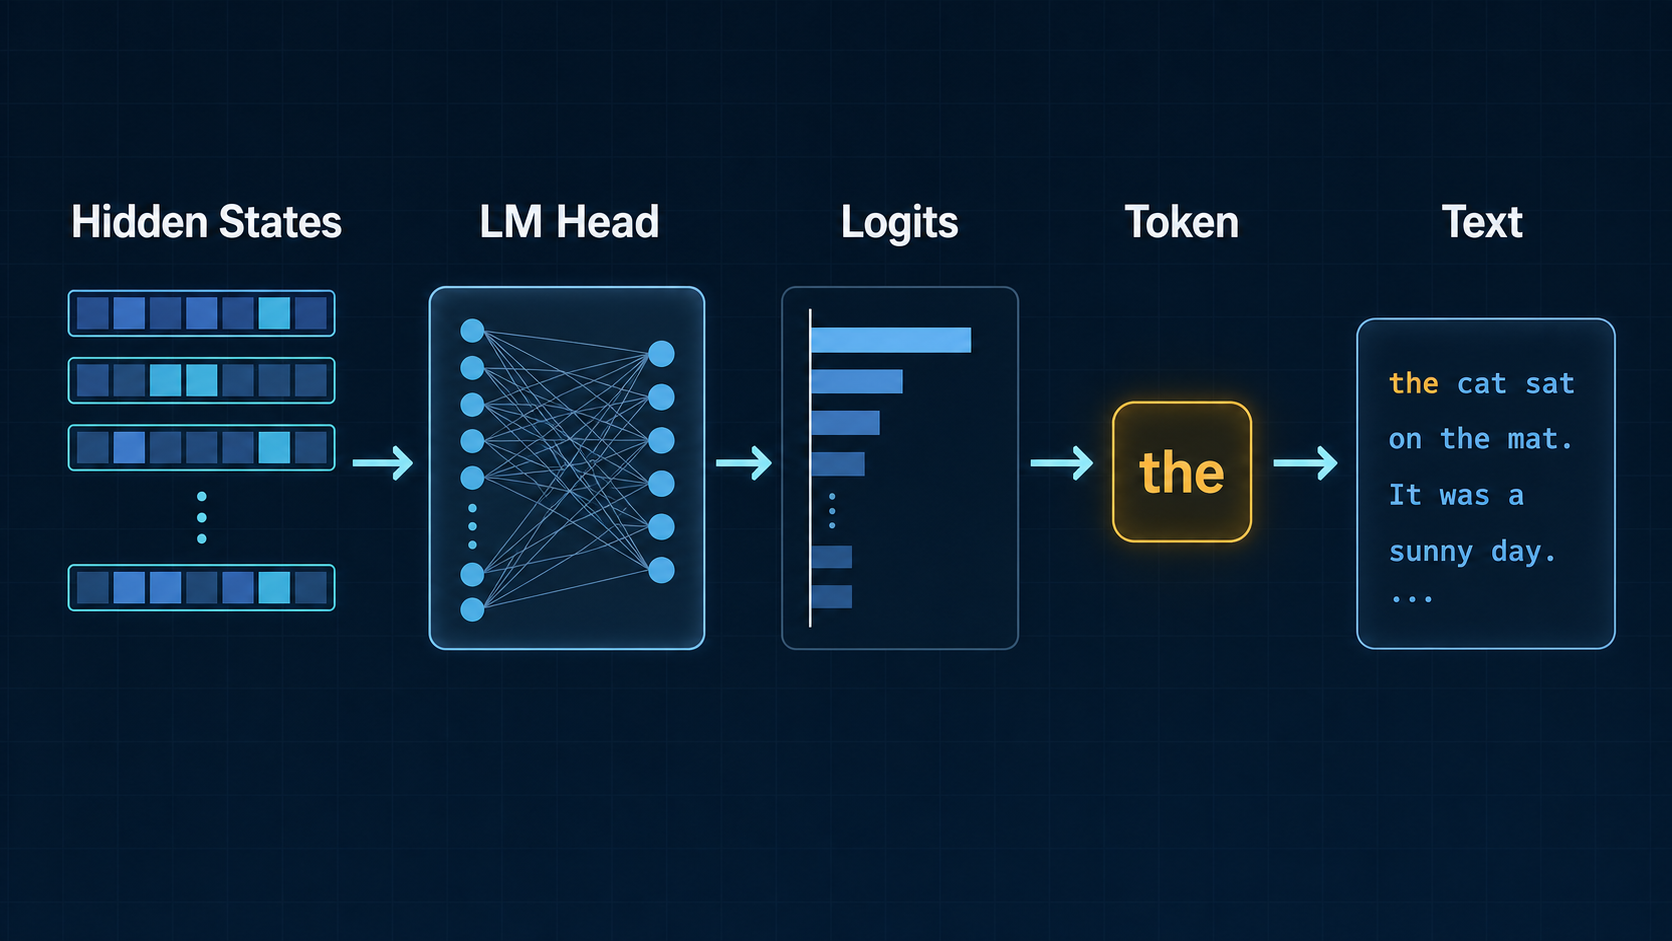
Hidden States [B, S, D]
  → Final Norm
  → Position Selection [B, K, D]
  → LM Head [B, K, V]
  → Logits Processing [B, V]
  → Token Selection [B]
  → Generation Loop
  → Tokenizer.decode
其中,
1. 输出投影
输出投影将 Decoder 的隐藏状态转换为词表中每个 token 的未归一化分数,即 logits。对于 Pre-Norm 模型,该阶段通常包含 Final Norm、预测位置选择和 LM Head 三个步骤。
1.1 Final Norm
Pre-Norm 模型在每个子模块之前执行归一化,但最后一个子模块的残差相加之后仍需一次 Final Norm。Qwen2 使用 RMSNorm:
其中,
1.2 预测位置
位置 logits_to_keep 控制该范围,避免计算无用的词表投影。批量生成应使用左侧 padding,确保 [:, -1, :] 对应有效 token。
1.3 LM Head
LM Head 是从隐藏维度到词表维度的线性投影:
其中,[B, K, D] 经投影后变为 [B, K, V]。
📄 transformers/.../modeling_qwen2.py#L392-L480
# Qwen2Model.forward
for decoder_layer in self.layers:
    hidden_states = decoder_layer(hidden_states, ...)

hidden_states = self.norm(hidden_states)
return BaseModelOutputWithPast(last_hidden_state=hidden_states, ...)


# Qwen2ForCausalLM.forward
hidden_states = outputs.last_hidden_state
slice_indices = (
    slice(-logits_to_keep, None)
    if isinstance(logits_to_keep, int)
    else logits_to_keep
)
logits = self.lm_head(hidden_states[:, slice_indices, :])
1.4 Weight Tying
Weight Tying 让输入 Embedding 与 LM Head 共享同一参数矩阵:
共享权重可减少 tie_word_embeddings=False,但加载具体模型时仍应以检查点配置和实际参数绑定关系为准。
2. Sampling
单步生成只使用最后一个预测位置的 logits,形状为 [B, V]。生成器先根据约束和采样参数处理 logits,再通过贪心或采样得到形状为 [B] 的下一个 token ID。
2.1 Logits 处理
logits 不是概率。Logits processor 会按配置顺序修改分数,并通常将不允许生成的 token 设为
| 参数 | 处理方式 | 作用 |
|---|---|---|
temperature | 调整采样分布的集中程度 | |
top_k | 保留分数最高的 | 限制候选集大小 |
top_p | 保留累计概率达到阈值的最小候选集 | 动态限制候选集 |
min_p | 保留 | 按最高概率的相对比例过滤 |
当 temperature 放大分数差异;当 temperature=0 不是合法的除数;确定性生成应设置 do_sample=False。
生成约束、重复惩罚和采样过滤器可能同时生效。由于这些变换通常不可交换,最终结果取决于处理器的实际执行顺序。
2.2 贪心与采样
设处理后的分数为
Sampling 则先将分数归一化为概率,再从分类分布中抽样:
两种方法的输出都是 token ID。对于相同分数,Greedy Decoding 的结果确定;Sampling 的结果还取决于随机数状态。
3. 生成循环
生成器将新 token 追加到当前序列,并重复执行模型前向、分数处理和 token 选择,直至所有序列满足停止条件。
3.1 Prefill 与 Decode
首次处理完整 prompt 的阶段称为 Prefill,之后逐 token 生成的阶段称为 Decode。启用 KV Cache 后,Decode 可以复用历史 Key 和 Value,只计算新增 token 对应的 Transformer 状态;这项优化不会改变 Final Norm、LM Head 或 token 选择的语义。
3.2 追加与停止
每轮生成完成 token 选择后,生成器依次执行以下操作:
- 已结束序列:将后续位置填充为 padding token。
- 未结束序列:将新 token 追加到
input_ids。 - 停止判断:检查 EOS、最大长度、
stop_strings、最大时间或自定义条件。 - 循环控制:仍有未结束序列时进入下一轮 Decode。
📄 transformers/generation/utils.py#L2857-L2952
outputs = self._prefill(input_ids, generation_config, model_kwargs, ...)

while self._has_unfinished_sequences(...):
    if prefill_consumed:
        next_sequence_length = 1 if model_kwargs["use_cache"] else None
        model_inputs = self.prepare_inputs_for_generation(
            input_ids,
            next_sequence_length=next_sequence_length,
            **model_kwargs,
        )
        outputs = model_forward(**model_inputs, return_dict=True)
    prefill_consumed = True

    next_token_logits = outputs.logits[:, -1].to(dtype=torch.float32)
    next_token_scores = logits_processor(input_ids, next_token_logits)

    if do_sample:
        probs = nn.functional.softmax(next_token_scores, dim=-1)
        next_tokens = torch.multinomial(probs, num_samples=1).squeeze(1)
    else:
        next_tokens = torch.argmax(next_token_scores, dim=-1)

    input_ids = torch.cat([input_ids, next_tokens[:, None]], dim=-1)
    unfinished_sequences = unfinished_sequences & ~stopping_criteria(input_ids, scores)
4. 文本解码
生成循环始终处理 token ID。循环结束后,Tokenizer 再将 token ID 序列转换为文本:
text = tokenizer.decode(generated_ids, skip_special_tokens=True)token 不等同于字符或单词。对于 Byte-level Tokenizer,单个 token 还可能只包含一个 UTF-8 字符的部分字节,因此流式输出应使用增量解码器或 streamer 维护解码缓冲区,不能简单地逐 token 独立解码后拼接。
skip_special_tokens=True 只控制最终文本是否展示特殊 token;EOS 等特殊 token 仍参与模型计算和停止判断。