数据传输优化专题
LLM 推理中的 CPU–GPU 传输不只有模型权重和 KV Cache,也包括每轮调度产生的 token、序列长度、请求索引,以及采样后的结果。一次传输即使只有几个字节,也可能让 CPU 等待前面整段 GPU 工作,打断调度与计算的流水线。
本文沿两个方向展开:H2D 关注如何异步提交数据,D2H 关注何时必须把 GPU 结果交给 CPU。前者涉及 non_blocking、Pinned Memory 和 Stream;后者涉及 .tolist()、.cpu()、.item(),以及依赖 CUDA Tensor 的 Python 条件判断。
CPU–GPU 数据传输
├── H2D:CPU → GPU
│   ├── non_blocking:减少 CPU 提交后的等待
│   ├── Pinned Memory:让锁页内存直接参与 DMA
│   └── 独立 Stream:让传输与无依赖的计算重叠
└── D2H:GPU → CPU
    ├── .tolist():转换为 Python 列表
    ├── .cpu():取得 CPU Tensor
    ├── .item():取得 Python 标量
    └── Python 条件判断:CPU 必须知道判断结果
下文以 PyTorch eager 模式和 CUDA 为例。接口名是 non_blocking、pin_memory 和 .tolist()。
1. 先区分提交、完成与同步
执行 y = model(x) 时,CPU 通常只是向 CUDA Stream 提交计算,函数返回并不意味着 GPU 已经算完。Stream 中的操作按顺序执行,CPU 可以继续准备或提交后续任务。
CPU:提交 A → 提交 B → 提交 C → 继续执行
GPU:         执行 A → 执行 B → 执行 C
当 CPU 必须取得 GPU 上的真实数据时,就需要等到相关结果可用。假设 A、B、C 已经排队,一次回读 C 的操作即使只传 8 字节,也需要先等 A、B、C 执行完成。
因此,在时间线上看到某次 .item() 或拷贝调用耗时 2 ms,不能直接认为“这几个字节传了 2 ms”。调用耗时可能包含此前未完成工作的等待。
| 概念 | 含义 | 常见误解 |
|---|---|---|
| CPU 提交耗时 | Python/CUDA 调用到返回的时间 | 返回就代表数据已经传完 |
| 完整完成耗时 | 从开始到相关 GPU 工作完成 | 可以用异步调用返回时间代替 |
| CPU–GPU 重叠 | CPU 工作与 GPU 工作同时进行 | 必须使用两个 CUDA Stream |
| GPU 传输–计算重叠 | DMA 拷贝与独立 Kernel 同时进行 | 加一个 non_blocking 就自动实现 |
CPU–GPU 重叠与 GPU 上的传输–计算重叠是两件事。单个 Stream 也可以让 CPU 提前执行;但同一个 Stream 中的 H2D 和后续 Kernel 仍然按序执行。PyTorch CUDA 执行语义
2. H2D:异步拷贝
2.1 从 Python 列表构造 CUDA Tensor
在调度代码里,常见的写法是:
input_ids = torch.tensor(last_tokens, dtype=torch.int64, device="cuda")Python 列表位于 CPU,指定 device="cuda" 并不会让 Python 元素直接在 GPU 上解析。常规构造路径先将列表转换成 CPU 上的连续 Tensor,再搬到目标设备;内部设备转换使用阻塞模式。PyTorch Tensor 构造源码
可以显式拆开:
input_ids = torch.tensor(
    last_tokens, dtype=torch.int64, device="cpu"
).to("cuda", non_blocking=True)
两种写法都需要执行:
Python 列表 → CPU 上的 int64 数据 → H2D → GPU Tensor改变的是提交后的等待行为。显式写 device="cpu" 也能避免默认设备被修改后,前半段意外创建 CUDA Tensor。
2.2 non_blocking:让 CPU 提前继续
在常见的 PyTorch CPU–CUDA 拷贝路径中,底层提交 cudaMemcpyAsync;默认阻塞路径随后执行 Stream 同步。设置 non_blocking=True 后,PyTorch 省掉这次显式同步等待。PyTorch 拷贝实现说明
blocking:
CPU:提交 H2D ── 等待完成 ── 后续 CPU 工作
GPU:             H2D

non_blocking:
CPU:提交 H2D → 后续 CPU 工作
GPU:             H2D
non_blocking=True 表示尽可能相对 CPU 异步执行。普通 CPU 内存传输可能触发驱动暂存或内部同步,所以不能保证整个调用完全不阻塞。Tensor.to 文档
同一 Stream 中,紧接着使用返回的 CUDA Tensor 是安全的:
x = cpu_tensor.to("cuda", non_blocking=True)
y = x + 1  # 同一 Stream:先完成 H2D,再执行加法
不需要为了这次 GPU 消费立刻调用 torch.cuda.synchronize();那会重新让 CPU 等待。换到其他 Stream 消费时,则需要建立对应的数据依赖。
2.3 Pinned Memory:减少中间暂存
普通 CPU Tensor 默认使用 Pageable Memory,即可分页内存。CUDA 传输时可能需要先将数据暂存到驱动管理的锁页缓冲,再交给 DMA 引擎:
Pageable CPU 内存 → Pinned 暂存内存 → GPU 显存
                    CPU 数据移动      DMA
Pinned Memory,也叫 Page-locked Memory,保证相关内存页驻留,并提供稳定的 DMA 映射。数据已经在这类内存里时,可以直接作为 DMA 传输来源:
Pinned CPU 内存 ───── DMA ─────→ GPU 显存锁页不要求整块物理内存连续,也不意味着普通内存每次传输都会发生磁盘换页。关键是驱动能否直接、稳定地使用这些内存页。CUDA API 同步与暂存语义
| 配置 | 传输路径 | CPU 等待行为 |
|---|---|---|
| Pageable + blocking | 可能需要中间暂存 | PyTorch 等待拷贝完成 |
| Pageable + non_blocking | 仍可能需要中间暂存 | 省掉显式等待,驱动仍可能阻塞 |
| Pinned + blocking | 可直接作为 DMA 源 | 仍然等待完成 |
| Pinned + non_blocking | 可直接作为 DMA 源 | 支持异步提交后继续 CPU 工作 |
Pinned Memory 不能替代 non_blocking,non_blocking 也不会自动把普通内存变成可复用的 pinned buffer。
2.4 为什么每次临时 pin 可能更慢
下面的写法会在调用线程上把普通 CPU Tensor 复制到 pinned 存储:
x = torch.tensor(last_tokens, dtype=torch.int64, device="cpu")
x_gpu = x.pin_memory().to("cuda", non_blocking=True)
这增加了 CPU 拷贝、Tensor 管理和 pinned allocator 的操作。即使分配器复用了缓存,复制数据的成本仍然存在。对于很小的 token 列表,这些开销可能超过异步传输的收益。
高频传输更适合提前申请、反复填充:
# 初始化阶段
host_buf = torch.empty(
    capacity, dtype=torch.int64, device="cpu", pin_memory=True
)
copy_done = None

# 调度循环示意,GPU 消费与 H2D 在同一 Stream
for last_tokens in batches:
    if copy_done is not None:
        copy_done.synchronize()  # 等上次 DMA 读完,才可覆盖源 buffer

    n = len(last_tokens)
    assert n <= capacity
    host_buf[:n].copy_(
        torch.tensor(last_tokens, dtype=torch.int64, device="cpu")
    )
    input_ids = host_buf[:n].to("cuda", non_blocking=True)
    copy_done = torch.cuda.current_stream().record_event()
    consume_on_gpu(input_ids)
这段代码省掉了每轮申请 pinned buffer,但仍包含“列表 → 普通 CPU Tensor → pinned buffer”。如果上游能直接写入 pinned buffer,还可以减少中间对象和拷贝。例如,在初始化时取得 host_buf.numpy() 零拷贝视图,再通过视图填入列表;列表到 int64 的转换仍然有成本。
复用需要区分两个生命周期:CPU 源 buffer 在 H2D 完成后才能覆盖;GPU 目标 buffer 在上一次消费者完成后才能覆盖。 双缓冲可以把下一批填充与上一批传输重叠,但每个槽位都需要管理完成事件。
2.5 独立 Stream:让 DMA 与计算重叠
如果 H2D 和计算都放在同一个 Stream,即使 CPU 不等待,GPU 仍然按序执行:
同一 Stream: [H2D][计算]使用独立 Stream,并且计算不依赖这次传入的数据,才有机会得到:
Copy Stream:     [下一批 H2D]
Compute Stream:  [当前批计算]
这需要可用的 DMA/计算硬件资源、适合异步传输的主机内存,以及正确的数据依赖。不能让某一批计算在自己的输入尚未拷完时开始读取。推理调度中的相关流水线见 Overlap Schedule。
3. H2D 实测:收益来自哪里
2026-09-06,在单张 NVIDIA H20 上测试了 92 组配置,共 5680 个计时样本,正确性检查全部通过。环境为 PyTorch 2.11.0+cu130、CUDA Runtime 13.0、Python 3.12.3;CPU 固定到 GPU 本地 NUMA 节点,使用单线程,不锁 GPU 时钟。
各组预热 10 次,随机交错方法顺序;列表和排队场景每方法 80 个样本,纯传输和 GEMM 重叠场景每方法 40 个样本。下面使用中位数:
- CPU 调用返回只测调用到返回。
- 完整完成包含最后的
torch.cuda.synchronize();每个样本开始也先同步。 - 列表场景包含列表到 Tensor 的转换,但不包含输入列表本身的生成;预分配场景不计初次分配和准备数据。
- 正确性回读和 Profiler 不计入正式计时。小 Tensor 的完成耗时包含末尾同步调用开销,不等同于纯 DMA 时间。
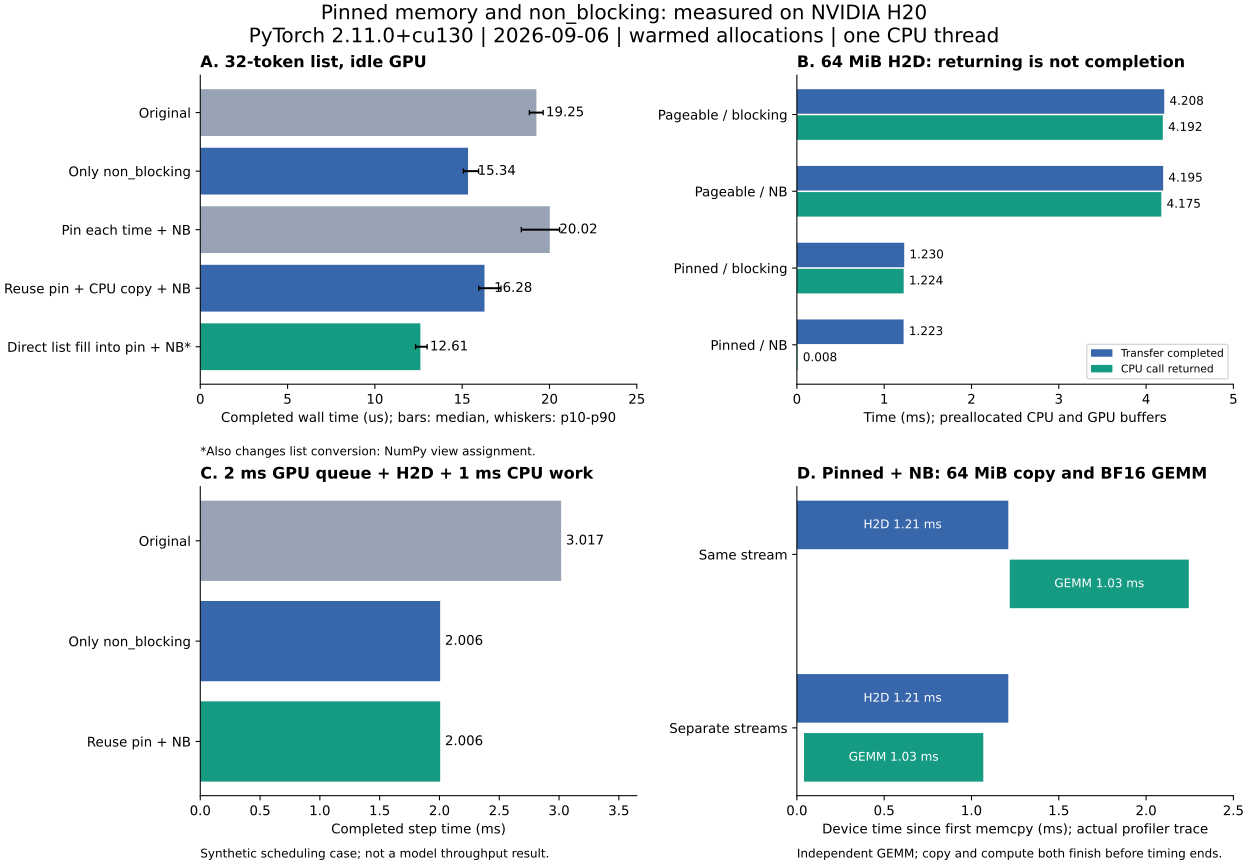
图 1:A–C 为重复测量统计,D 为单独采集的实际 GPU memcpy/kernel 轨迹。点击查看大图。
3.1 小 token 列表:减少同步比临时 pin 更划算
| 方法 | 32 token 完成耗时 | 8192 token 完成耗时 |
|---|---|---|
原始 torch.tensor(..., device="cuda") | 19.25 μs | 462.64 μs |
| CPU Tensor + non_blocking | 15.34 μs | 452.05 μs |
每次 .pin_memory() + non_blocking | 20.02 μs | 455.66 μs |
| 复用 pinned,仍先构造 CPU Tensor 再填入 | 16.28 μs | 454.69 μs |
| 列表直接填入复用 pinned 的 NumPy 视图 + non_blocking | 12.61 μs | 266.34 μs |
32 token 下,仅改 non_blocking 得到 1.26× 加速,完成时间减少约 20%。临时 pin 反而略慢;复用 pinned、但保留中转 CPU Tensor,也没有超过单改 non_blocking。
最后一行同时优化了列表转换路径、减少中间 Tensor,不能把全部提升归因于 pin。列表增大后,CPU 转换开销越来越突出;测试到 131072 token 时,原始与单改 non_blocking 分别为 6.896 ms 和 6.887 ms,差距很小。
3.2 64 MiB:传得更快与返回更早
CPU 源与 GPU 目标均提前分配,执行 dst.copy_(src, non_blocking=nb):
| CPU 源 | non_blocking | CPU 调用返回 | 完整完成 |
|---|---|---|---|
| Pageable | False | 4.192 ms | 4.208 ms |
| Pageable | True | 4.175 ms | 4.195 ms |
| Pinned | False | 1.224 ms | 1.230 ms |
| Pinned | True | 0.008 ms | 1.223 ms |
提前准备好 pinned 数据后,完整传输约改善 3.44×。同为 pinned 时,non_blocking 对完整传输时间影响很小,但 CPU 从等待约 1.22 ms,变成约 8 μs 就返回。
这里的 8 μs 不是传完 64 MiB 的时间。普通内存加 non_blocking 也没有明显减少调用耗时,说明本次大块传输的驱动路径仍然显著阻塞。不能把预分配场景的提升直接套到从 Python 列表开始的完整流程。
3.3 连续小拷贝:同步成本累积
预分配源和目标,连续提交 32 次 64 KiB 拷贝,最后统一等待:
| 配置 | 32 次拷贝完整完成 |
|---|---|
| Pageable + blocking | 561.71 μs |
| Pageable + non_blocking | 260.57 μs |
| Pinned + blocking | 358.14 μs |
| Pinned + non_blocking | 125.75 μs |
组合相对本组 Pageable + blocking 基线达到 4.47×。non_blocking 减少每次拷贝后的等待,使提交更密集;pin 减少中间暂存。32 次 DMA 仍在同一 Stream 顺序执行。实验反复覆盖同一目标,仅用于隔离提交和传输成本,不代表 32 批数据的完整消费流程。
3.4 前面已有 GPU 工作:小 H2D 也可能等 2 ms
构造同一 Stream 中的受控场景:先排入约 2 ms GPU 工作,传入 32 个 token,再做 1 ms CPU 工作,最后由 GPU 消费 token。
| 配置 | H2D 的 Python 调用耗时 | 整段完成 |
|---|---|---|
| 原始列表直接构造 CUDA Tensor | 2001.77 μs | 3.017 ms |
| CPU Tensor + non_blocking | 10.91 μs | 2.006 ms |
| 复用 pinned + CPU copy + non_blocking | 12.32 μs | 2.006 ms |
原始调用必须等待 H2D 完成,也就先等了 Stream 前面的约 2 ms 工作,CPU 的 1 ms 工作只能随后执行。non_blocking 提前返回后,这 1 ms CPU 工作与前面的 GPU 工作重叠,整段约 1.50×。
这台机器上的 256 B Pageable 源也能快速返回,因此额外 pin 没有明显收益。实验中的 GPU _sleep 与 CPU 忙等用于隔离等待关系,不是某个真实模型的吞吐测试。
3.5 H2D 与真实 GEMM 重叠
64 MiB H2D 加一次独立的 4096×4096 BF16 GEMM,先提交拷贝,再提交计算。计算使用已有 GPU 数据,不消费本次 H2D 的结果:
| 配置 | 整段完成 |
|---|---|
| 仅 pinned H2D | 1.224 ms |
| 仅 GEMM | 1.043 ms |
| Pinned + blocking,独立 Stream | 2.276 ms |
| Pinned + non_blocking,同 Stream | 2.266 ms |
| Pinned + non_blocking,独立 Stream | 1.235 ms |
固定 pinned + non_blocking,只改变 Stream 组织就得到 1.84×。Profiler 确认独立 Stream 下实际 memcpy 与 Kernel 区间重叠;同 Stream 则先传输、再计算。
blocking 配置虽然用了独立 Stream,但 CPU 要等拷贝完成才能提交后面的 GEMM,因此这个提交顺序下没有重叠。提交顺序、数据依赖和内存类型必须一起分析。
4. D2H:隐式同步
H2D 可以让 CPU 在提交后继续工作;D2H 则经常发生在 CPU 需要读取结果的位置。即使传输能够异步提交,CPU 真正使用数据前仍然必须等它就绪。优化的方向通常是减少回读次数、减少回读数据量,或将消费时机后移。
以下是 API 语义和代码示例,不是上面 H20 实验测得的 D2H 加速结果。
4.1 .tolist():Python 列表需要真实数据
next_tokens = next_token_ids.tolist() # next_token_ids 在 CUDA 上.tolist() 返回 Python 标量或嵌套列表;如果 Tensor 在 GPU 上,会先自动移到 CPU。它既包含 D2H 和相关等待,也包含 Python 对象构造。Tensor.tolist 文档
如果接下来还要把同一批 token 送回 GPU,会形成一次往返:
tokens = next_token_ids.tolist()  # GPU → CPU,等待并生成列表
input_ids = torch.tensor(tokens, dtype=torch.int64, device="cuda")
如果下一轮计算仍能使用 GPU 数据,可以保留 Tensor,必要时在 GPU 上进行 Gather、重排或 dtype 转换。CPU 的输出、停止条件检查则在需要时处理,避免为了 GPU 到 GPU 的接力先绕回 CPU。
这要求保留真实的数据依赖;例如自回归 Decode 的下一轮必须等待上一轮 token 产生,只是这个等待可以放在 GPU Stream 中,而不必由 CPU 读取 token 来串联。
4.2 .cpu():拷回 CPU 的默认完成边界
cpu_tokens = next_token_ids.cpu()
tokens = cpu_tokens.tolist()
当源在 CUDA 上时,普通 .cpu() 返回后可以读取 CPU Tensor,因此调用可能等待 GPU 生产和拷贝完成。紧接着的 .tolist() 只处理 CPU 数据,等待已经发生在前一行。若源本来就在 CPU 上,.cpu() 则不需要设备传输。Tensor.cpu 文档
.cpu() 没有 non_blocking 参数。可以使用 .to("cpu", non_blocking=True) 或向预分配 pinned CPU 目标执行 copy_,但不能在函数返回后立即假定 CPU 数据已经有效。
# 错误用法:异步 D2H 可能尚未完成
cpu_tokens = next_token_ids.to("cpu", non_blocking=True)
tokens = cpu_tokens.tolist()
CPU 上的 .tolist() 不会替你追踪此前 CUDA 拷贝是否完成;此时可能读到尚未写好的数据。detach() 也不能解决这个问题,它只影响 Autograd,不会拷贝数据或等待 CUDA。
4.3 .item():一个标量也能成为同步点
token = next_token_ids[0].item().item() 将单元素 Tensor 转成 Python 数字。CPU 要拿到这个值,必须等 GPU 先把它算出来。多元素 Tensor 不能直接调用 .item()。Tensor.item 文档
逐元素回读会反复跨越这个边界:
# 多次标量回读与 Python 调用
tokens = [next_token_ids[i].item() for i in range(batch_size)]

# CPU 确实需要整批结果时,集中回读
tokens = next_token_ids.tolist()
后一种仍然需要同步,但可以减少逐元素回读和调用次数。若 CPU 只需要一个汇总值,可以先在 GPU 上归约,再回读一次标量;如果 CPU 暂时不需要值,则继续保留 GPU Tensor。
性能统计和日志也可能引入 .item()。例如每轮将 CUDA 上的统计值转成 Python 数字再打印,会把观察代码放进推理关键路径,可以考虑按需汇总、降低频率或延后读取。
4.4 条件判断:隐式读取 GPU 标量
代码没有写 .cpu() 或 .item(),也可能触发相同的等待:
if (next_token_ids == eos_token_id).any():
    handle_finished_requests()
比较和 .any() 在 GPU 上执行,返回单元素 CUDA Tensor。但 Python 的 if 需要 CPU 上的布尔值,因此条件转换时必须等待结果。使用 bool(cuda_scalar),或让 Python while、and、or 对 CUDA Tensor 求真值,也会遇到类似边界。PyTorch 性能指南
可以将适合的数据选择保留在 GPU:
# 假设 x 是 CUDA Tensor,CPU 只用于决定逐元素符号处理
if (x.sum() > 0).item():
    y = x
else:
    y = -x

# 相同数值选择在 GPU 上完成
y = torch.where(x.sum() > 0, x, -x)这并不适用于所有分支。torch.where 的两个分支值在选择前已经求值,不能把 torch.where(cond, expensive_a(), expensive_b()) 当成只执行一条路径的 Python if。终止请求、发送网络响应等 CPU 副作用,也不能简单改写成 Tensor 选择。
判断是否同步,要看条件是否依赖 GPU 中的数据,而不是只看有没有 if:
| 判断或访问 | eager 模式下是否需要读取 GPU 数据 |
|---|---|
if cuda_scalar: | 需要取得标量值 |
if mask.any(): | 若 mask 在 CUDA 上,需要取得归约结果 |
if x.numel() > 0: | 通常只读 Tensor 元数据 |
if x.shape[0] > 0: | 通常只读形状元数据 |
if cpu_finished_count > 0: | 已有 CPU 值,不触发 D2H |
直接对多元素 Tensor 求 Python 布尔值通常会报“布尔值不明确”,不会自动替你执行 any()。另外,CUDA 上的 nonzero() 等操作也可能因需要确定输出大小而发生同步,不能仅靠搜索 .cpu() 找全同步点。
4.5 异步 D2H:先提交,后消费
当 CPU 有其他工作可做时,可以先把 GPU 结果异步拷回 pinned CPU buffer,在真正消费前等待事件。下面是单次传输的完整示例:
import torch

device = torch.device("cuda:0")
with torch.cuda.device(device):
    producer = torch.cuda.current_stream()
    copy_stream = torch.cuda.Stream()

    # 此例由 producer 生成数据
    gpu_result = torch.arange(32, dtype=torch.int64, device=device)
    host_result = torch.empty(
        gpu_result.shape,
        dtype=gpu_result.dtype,
        device="cpu",
        pin_memory=True,
    )
    copied = torch.cuda.Event()

    # GPU 依赖:等待 producer 已提交的工作,CPU 不在这里等待
    copy_stream.wait_stream(producer)
    with torch.cuda.stream(copy_stream):
        host_result.copy_(gpu_result, non_blocking=True)
        copied.record()

    # 防止源显存被 allocator 过早复用;不替代写入依赖
    gpu_result.record_stream(copy_stream)

    # 此处可以执行不依赖 host_result 的 CPU 工作

    copied.synchronize()  # CPU 读取前,明确等待本次 D2H 完成
values = host_result.tolist()这里有两个不同的等待:copy_stream.wait_stream(producer) 建立 GPU 生产到拷贝的依赖,CPU 可以继续执行;copied.synchronize() 则在 CPU 消费边界等待。
示例保留源和目标直到完成。生产代码若复用 buffer,还必须保证 GPU 源在 D2H 读取期间不被覆盖,CPU 目标在拷贝完成前不被读取,在 CPU 消费结束前也不被下一次传输覆盖。record_stream() 解决 allocator 生命周期问题,不会阻止其他代码改写源 Tensor。
如果提交后马上等待,收益可能很小。调度系统通常通过队列延后消费,例如提交当前轮计算后再处理上一轮结果;结束状态和输出依赖也必须随之正确处理,不能只移动一个 .cpu() 调用就认为流水线已经完成。Overlap Schedule 的结果处理
5. 定位与验证
先检查每一处传输的源、目标以及真正消费位置,再判断能否消除、合并或延后。一次优化可能只是把等待从 .cpu() 移到了后面的事件同步,单看某个函数变快不够。
| 现象 | 重点检查 | 优化方向 |
|---|---|---|
| 小 token H2D 调用耗时很长 | 是否等待 Stream 前面的工作 | non_blocking、避免过早同步 |
| 大块 H2D 调用仍然阻塞 | 源是否 Pageable、是否有中间暂存 | 提前准备 pinned buffer |
| 加 pin 后变慢 | 每轮分配、CPU 拷贝、列表转换 | 复用、直接填充,或保留普通内存 |
每轮 .item() / .tolist() | CPU 是否立刻需要结果 | 合并回读、GPU 接力、延后消费 |
| Python 条件造成 GPU 空隙 | 条件是否依赖 CUDA 标量 | 适合时使用 GPU 选择,或调整调度 |
| 异步 D2H 偶发错误 | CPU 是否在完成前读取 | 在消费位置等待 Event |
测量完成耗时应包含同步:
import time

# 预热后再测,run_case 表示待比较的完整操作
torch.cuda.synchronize()
t0 = time.perf_counter()
result = run_case()
t1 = time.perf_counter()
torch.cuda.synchronize()
t2 = time.perf_counter()

print("CPU return:", t1 - t0)
print("Completed:", t2 - t0)
这适合比较隔离操作。判断流水线收益时,还要测包含生产、传输、消费和最终排空的整段耗时;否则可能只测到了“提前返回”。Profiler 中应同时看 CPU 的 CUDA 调用、同步操作、GPU memcpy 和 Kernel 时间线,确认是否真的发生重叠。
6. 实验数据与复现
本文 H20 数字来自同一次运行,可下载 基准脚本、汇总 CSV 和 原始样本 JSON。原始数据包含各组的样本、p10/p90/min、中位数和正确性状态。
脚本依赖 PyTorch 和 NumPy,从 Git 工作目录运行以记录源码版本。确认目标 GPU 空闲后显式设置 CUDA_VISIBLE_DEVICES,为 --output 传入尚不存在的新目录:
python3 benchmark_h2d_pinned.py --output ./h2d-results-new --repeats 80这些结果是单机单卡、预热后的 eager microbenchmark。它们说明不同配置如何影响传输和等待,不代表真实 SGLang 服务必然获得相同加速比。最终应在实际 batch 大小、数据准备方式和消费依赖下验证端到端延迟与吞吐。